Ingestão de dados na nuvem para o Amazon S3
Esta página reúne tudo o que você precisa para sincronizar dados do Amazon S3 com a Braze usando a ingestão de dados na nuvem (CDI): os recursos da AWS que você precisa criar, como conectar a fonte e criar uma sincronização na Braze, o formato de arquivo de cada tipo de dado e a solução de problemas específicos do S3.
Como funciona
As integrações com o Amazon S3 são orientadas por eventos, e não agendadas. Quando novos arquivos são publicados no S3, uma mensagem é enviada para uma fila do Amazon Simple Queue Service (SQS). Então, a Braze consome essa mensagem para fazer a ingestão do novo arquivo.
A integração exige os seguintes recursos:
- Bucket S3 para armazenamento de dados
- Fila SQS para notificações de novos arquivos
- Função IAM para o acesso da Braze
Definições da AWS
| Termo | Definição |
|---|---|
| Amazon Resource Name (ARN) | O ARN é um identificador exclusivo para recursos da AWS. |
| Identity and Access Management (IAM) | O IAM é um serviço web que permite controlar com segurança o acesso aos recursos da AWS. Neste tutorial, você cria uma política IAM e a atribui a uma função IAM para integrar seu bucket S3 com a ingestão de dados na nuvem da Braze. |
| Amazon Simple Queue Service (SQS) | O SQS é uma fila hospedada que permite integrar sistemas e componentes de software distribuídos. |
Configurar a ingestão de dados na nuvem na AWS
Etapa 1: Criar um bucket de origem
Crie um bucket S3 de uso geral com as configurações padrão na sua conta da AWS. Os buckets S3 podem ser reutilizados em várias sincronizações, desde que a pasta seja exclusiva.
As configurações padrão são:
- ACLs desativadas
- Bloquear todo o acesso público
- Desativar o versionamento do bucket
- Criptografia SSE-S3
- O SSE-S3 é o único tipo de criptografia do lado do servidor compatível. A criptografia do Amazon KMS não é compatível.
Anote a região em que você criou o bucket. Você vai criar uma fila SQS na mesma região na próxima etapa.
Etapa 2: Criar a fila SQS
Crie uma fila SQS para rastrear quando objetos forem adicionados ao bucket que você criou. Por enquanto, use as configurações padrão.
Uma fila SQS precisa ser globalmente exclusiva (por exemplo, só pode ser usada em uma sincronização da CDI e não pode ser reutilizada em outro espaço de trabalho).
Crie essa fila SQS na mesma região em que você criou o bucket.
Anote o ARN e a URL da fila SQS. Você vai precisar deles com frequência durante esta configuração.
Etapa 3: Configurar a política de acesso
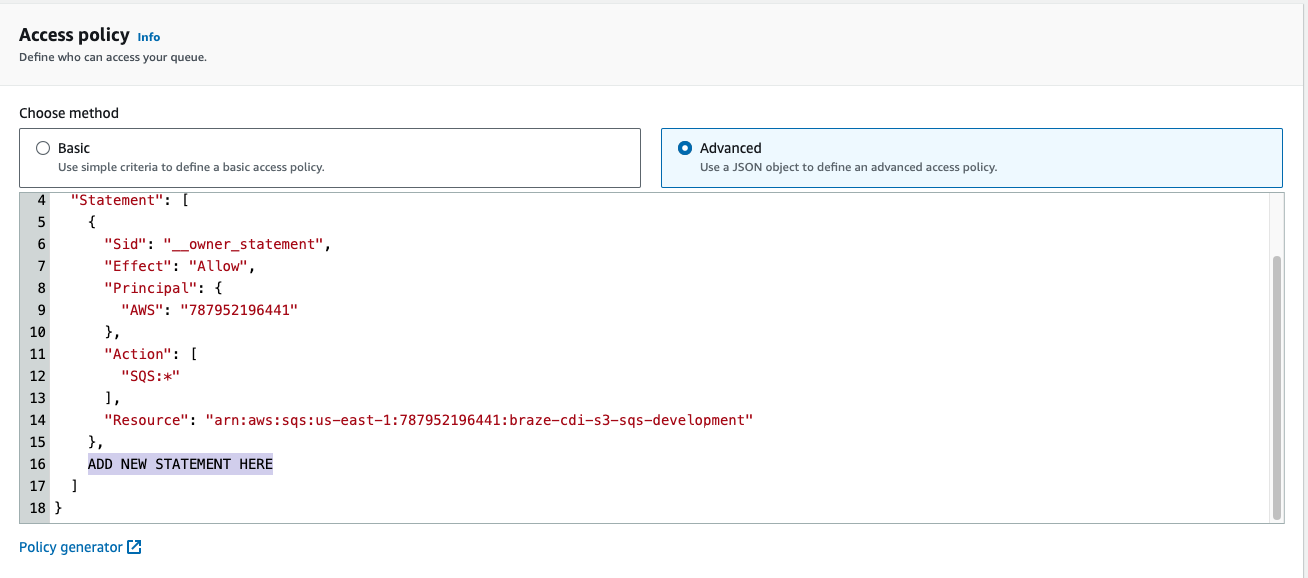
Para configurar a política de acesso, escolha Advanced options.
Adicione a seguinte instrução à política de acesso da fila, substituindo YOUR-BUCKET-NAME-HERE pelo nome do seu bucket, YOUR-SQS-ARN pelo ARN da sua fila SQS e YOUR-AWS-ACCOUNT-ID pelo ID da sua conta da AWS:
{
"Sid": "braze-cdi-s3-sqs-publish",
"Effect": "Allow",
"Principal": {
"Service": "s3.amazonaws.com"
},
"Action": "SQS:SendMessage",
"Resource": "YOUR-SQS-ARN",
"Condition": {
"StringEquals": {
"aws:SourceAccount": "YOUR-AWS-ACCOUNT-ID"
},
"ArnLike": {
"aws:SourceArn": "arn:aws:s3:::YOUR-BUCKET-NAME-HERE"
}
}
}
Etapa 4: Adicionar uma notificação de evento ao bucket S3
- No bucket criado na etapa 1, acesse Properties > Event notifications.
- Dê um nome à configuração. Se quiser que a Braze faça a ingestão de apenas um subconjunto de arquivos, você pode especificar um prefixo ou sufixo como alvo.
- Em Destination, selecione SQS queue e informe o ARN da fila SQS que você criou na etapa 2.
Se você fizer upload dos seus arquivos para a pasta raiz de um bucket S3 e depois mover alguns deles para uma pasta específica do bucket, poderá encontrar um erro inesperado. Em vez disso, você pode alterar as notificações de evento para que sejam enviadas apenas para os arquivos do prefixo, evitar colocar arquivos no bucket S3 fora desse prefixo ou atualizar a integração sem prefixo, o que fará a ingestão de todos os arquivos.
Etapa 5: Criar uma política IAM
Crie uma política IAM para permitir que a Braze interaja com seu bucket de origem. Para começar, faça login no console de gerenciamento da AWS como administrador da conta.
-
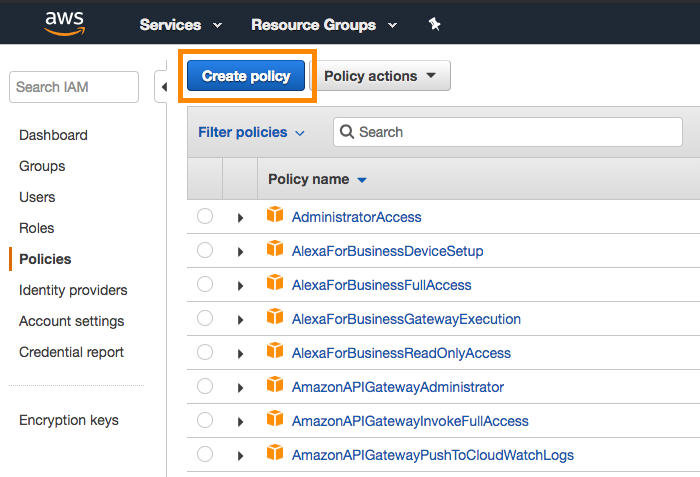
Acesse a seção IAM do console da AWS, selecione Policies na barra de navegação e depois selecione Create Policy.
-
Abra a guia JSON e insira o seguinte snippet de código na seção Policy Document, substituindo
YOUR-BUCKET-NAME-HEREpelo nome do seu bucket eYOUR-SQS-ARN-HEREpelo nome da sua fila SQS:
{
"Version": "2012-10-17",
"Statement": [
{
"Effect": "Allow",
"Action": ["s3:ListBucket", "s3:GetObjectAttributes", "s3:GetObject"],
"Resource": ["arn:aws:s3:::YOUR-BUCKET-NAME-HERE"]
},
{
"Effect": "Allow",
"Action": ["s3:ListBucket", "s3:GetObjectAttributes", "s3:GetObject"],
"Resource": ["arn:aws:s3:::YOUR-BUCKET-NAME-HERE/*"]
},
{
"Effect": "Allow",
"Action": [
"sqs:DeleteMessage",
"sqs:GetQueueUrl",
"sqs:ReceiveMessage",
"sqs:GetQueueAttributes"
],
"Resource": "YOUR-SQS-ARN-HERE"
}
]
}
-
Ao terminar, selecione Review Policy.
-
Dê um nome e uma descrição à política e selecione Create Policy.
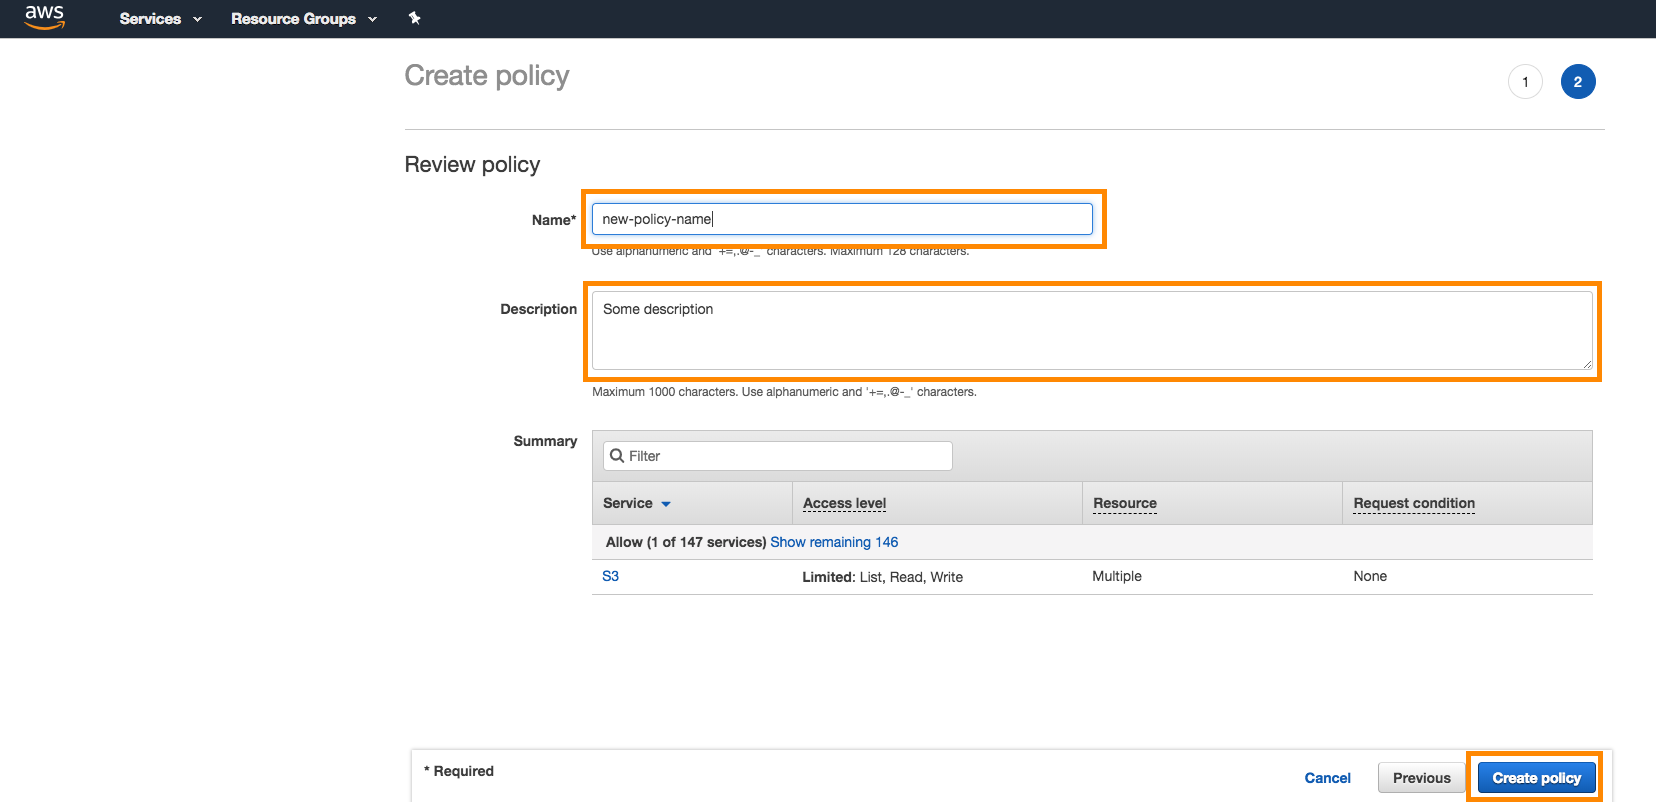
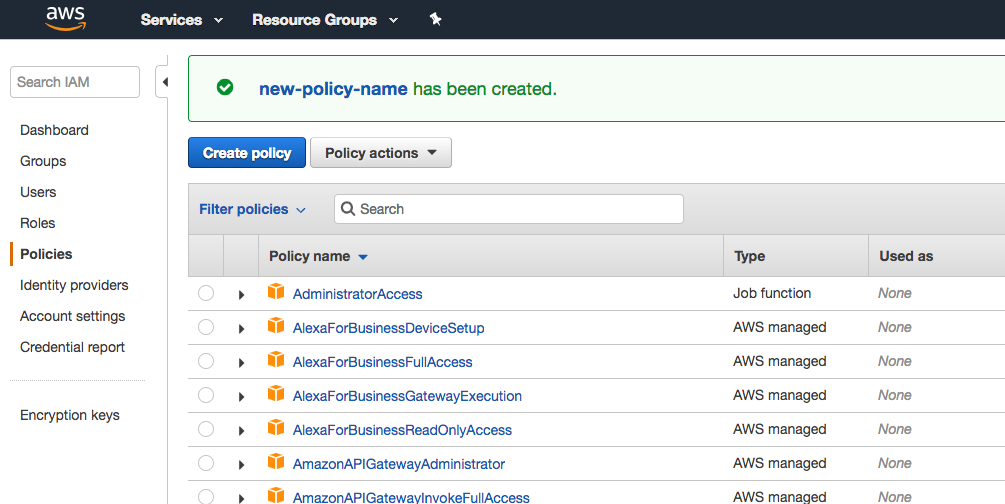
Etapa 6: Configurar a autenticação
A Braze acessa seu bucket e sua fila com o seguinte método de autenticação:
| Método | Como a Braze faz a autenticação | O que você insere na Braze |
|---|---|---|
| IAM role | Braze assumes an AWS Identity and Access Management (IAM) role in your account, using an external ID. | Role ARN and External ID |
IAM role
A Braze assume uma função do IAM na sua conta da AWS. Crie a função e anexe a ela a política do IAM que você criou.
- Na mesma seção do IAM do console em que você criou a política do IAM, acesse Roles > Create Role.
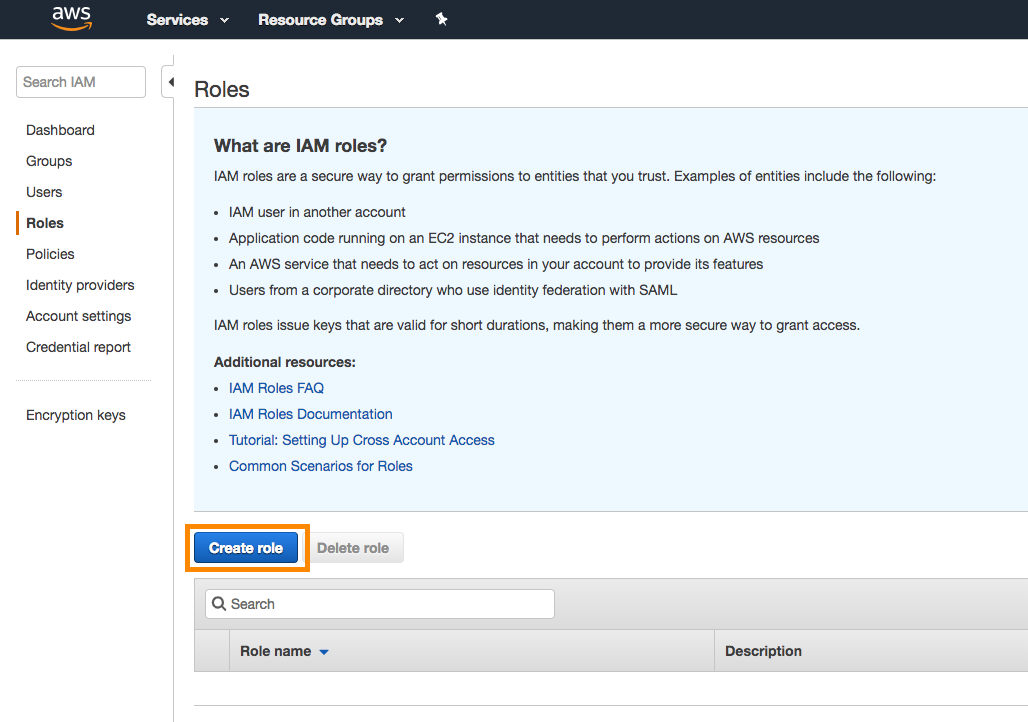
- Na AWS, selecione Another AWS Account como o tipo de seletor de entidade confiável. Informe o ID da sua conta Braze. Marque a caixa de seleção Require external ID.
- Na Braze, acesse Data Settings > Cloud Data Ingestion > Sources, selecione Add data source e selecione Amazon S3 na seção de fontes de arquivos.
- Copie o Braze Account ID gerado automaticamente.
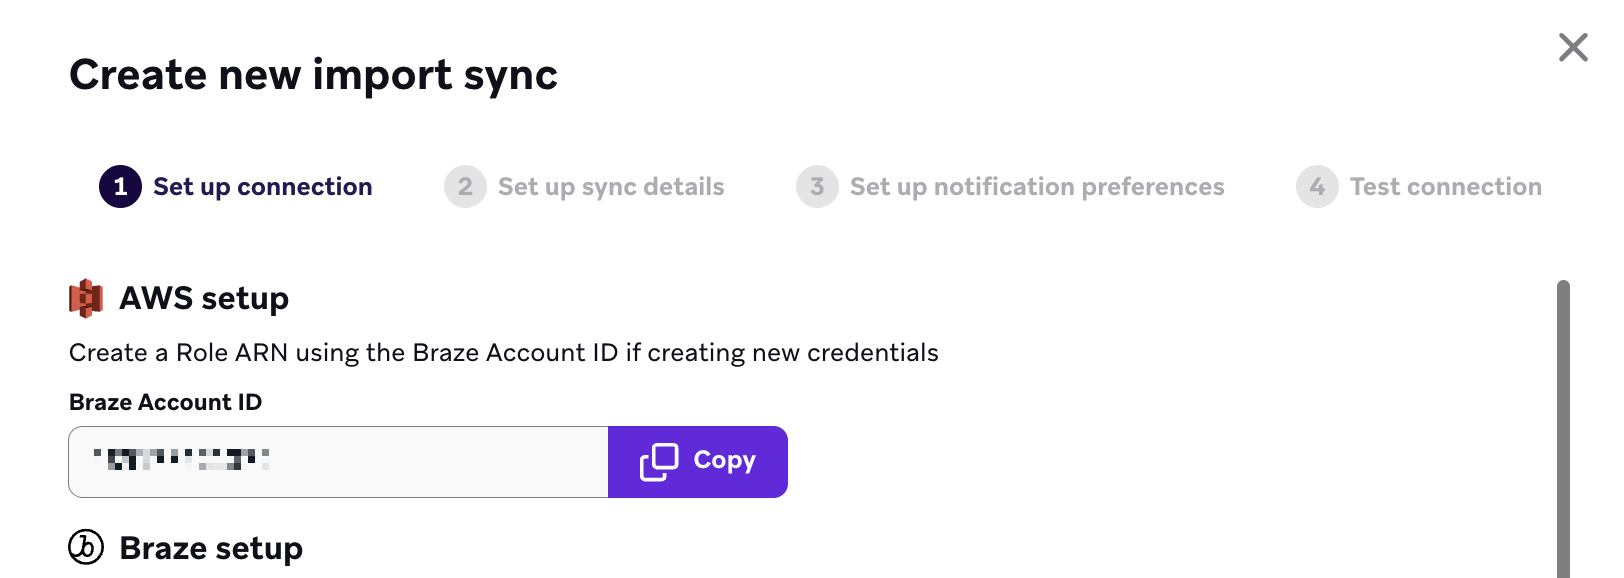
- Na AWS, cole o ID da conta e selecione Next.
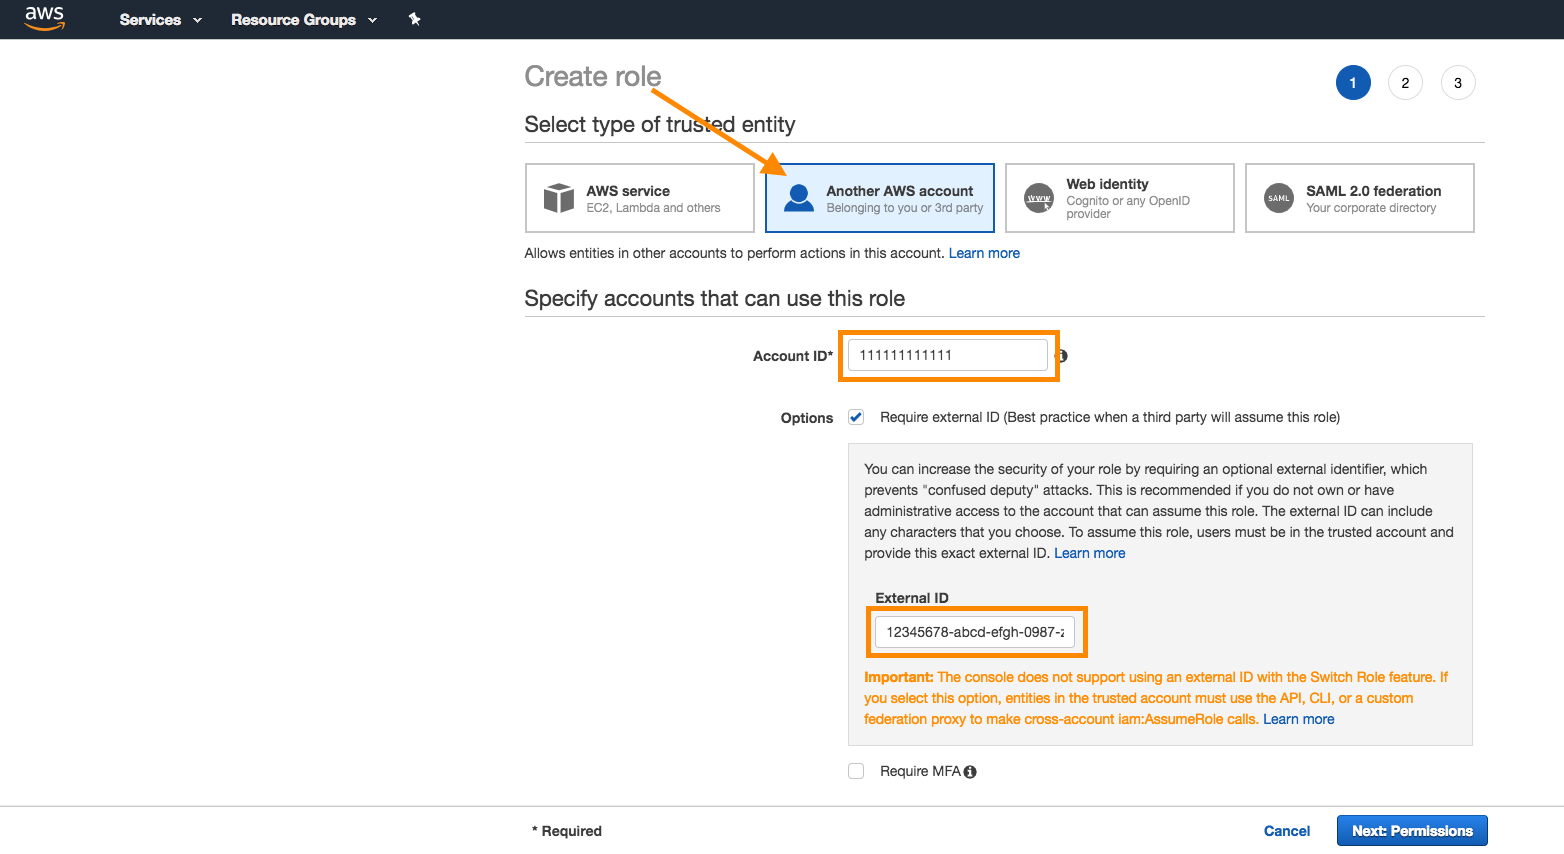
- Anexe a política do IAM à função. Pesquise a política na barra de pesquisa e marque a caixa ao lado dela para anexá-la. Selecione Next quando terminar.
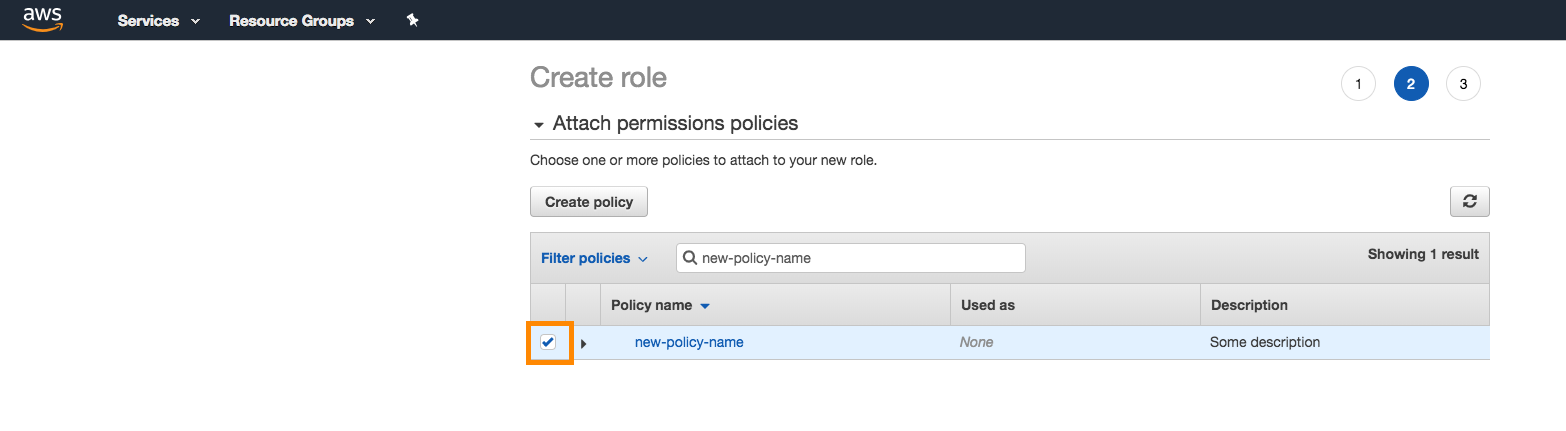
- Dê um nome e uma descrição à função e selecione Create Role.
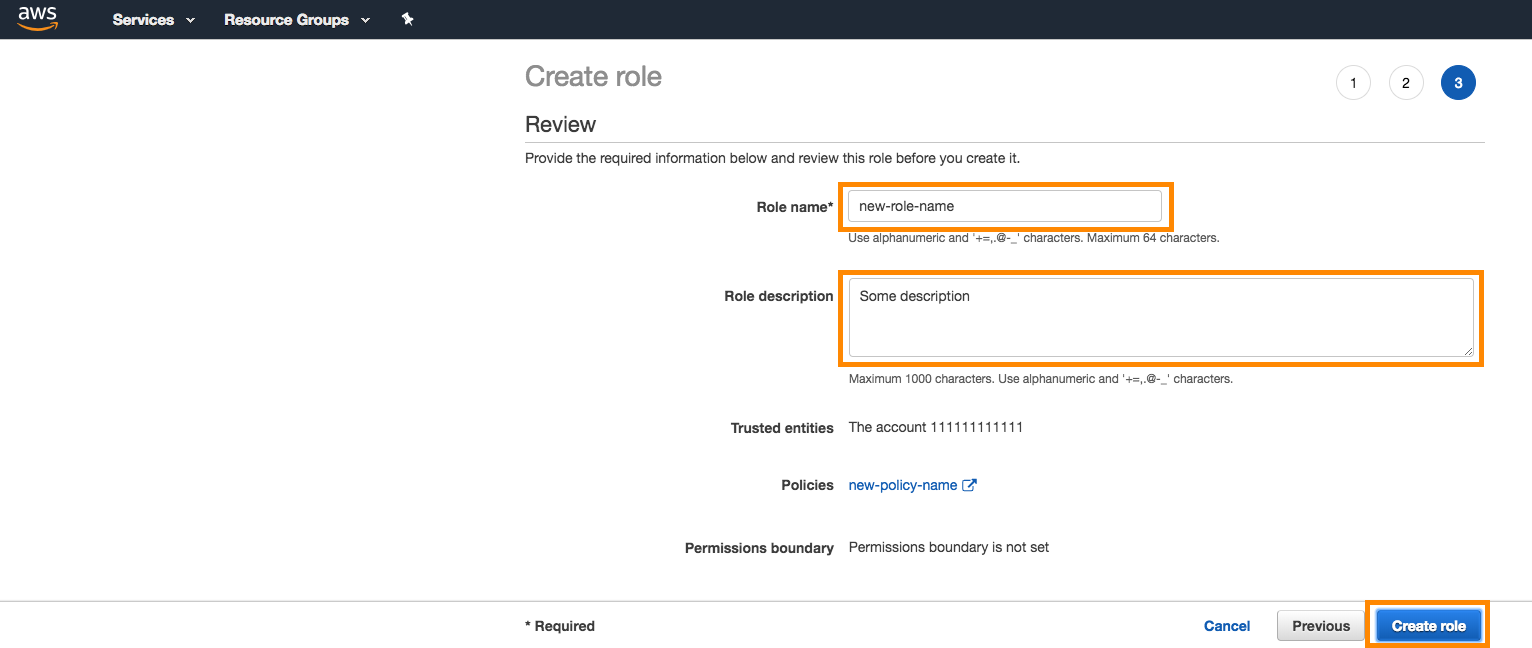
- Anote o ARN da função que você criou e o ID externo que você gerou. Você vai precisar deles para criar a integração de ingestão de dados na nuvem.
Configurar a ingestão de dados na nuvem na Braze
- Primeiro, crie uma nova fonte no dashboard da Braze. Acesse Configurações de dados > Ingestão de dados na nuvem > Fontes, selecione Adicionar fonte de dados e depois selecione Amazon S3.
- Escolha um nome para a fonte e insira as informações do processo de configuração da AWS para criar uma nova fonte. Especifique o seguinte:
- As credenciais do seu método de autenticação. Insira Role ARN and External ID.
- Nome do bucket
- Região
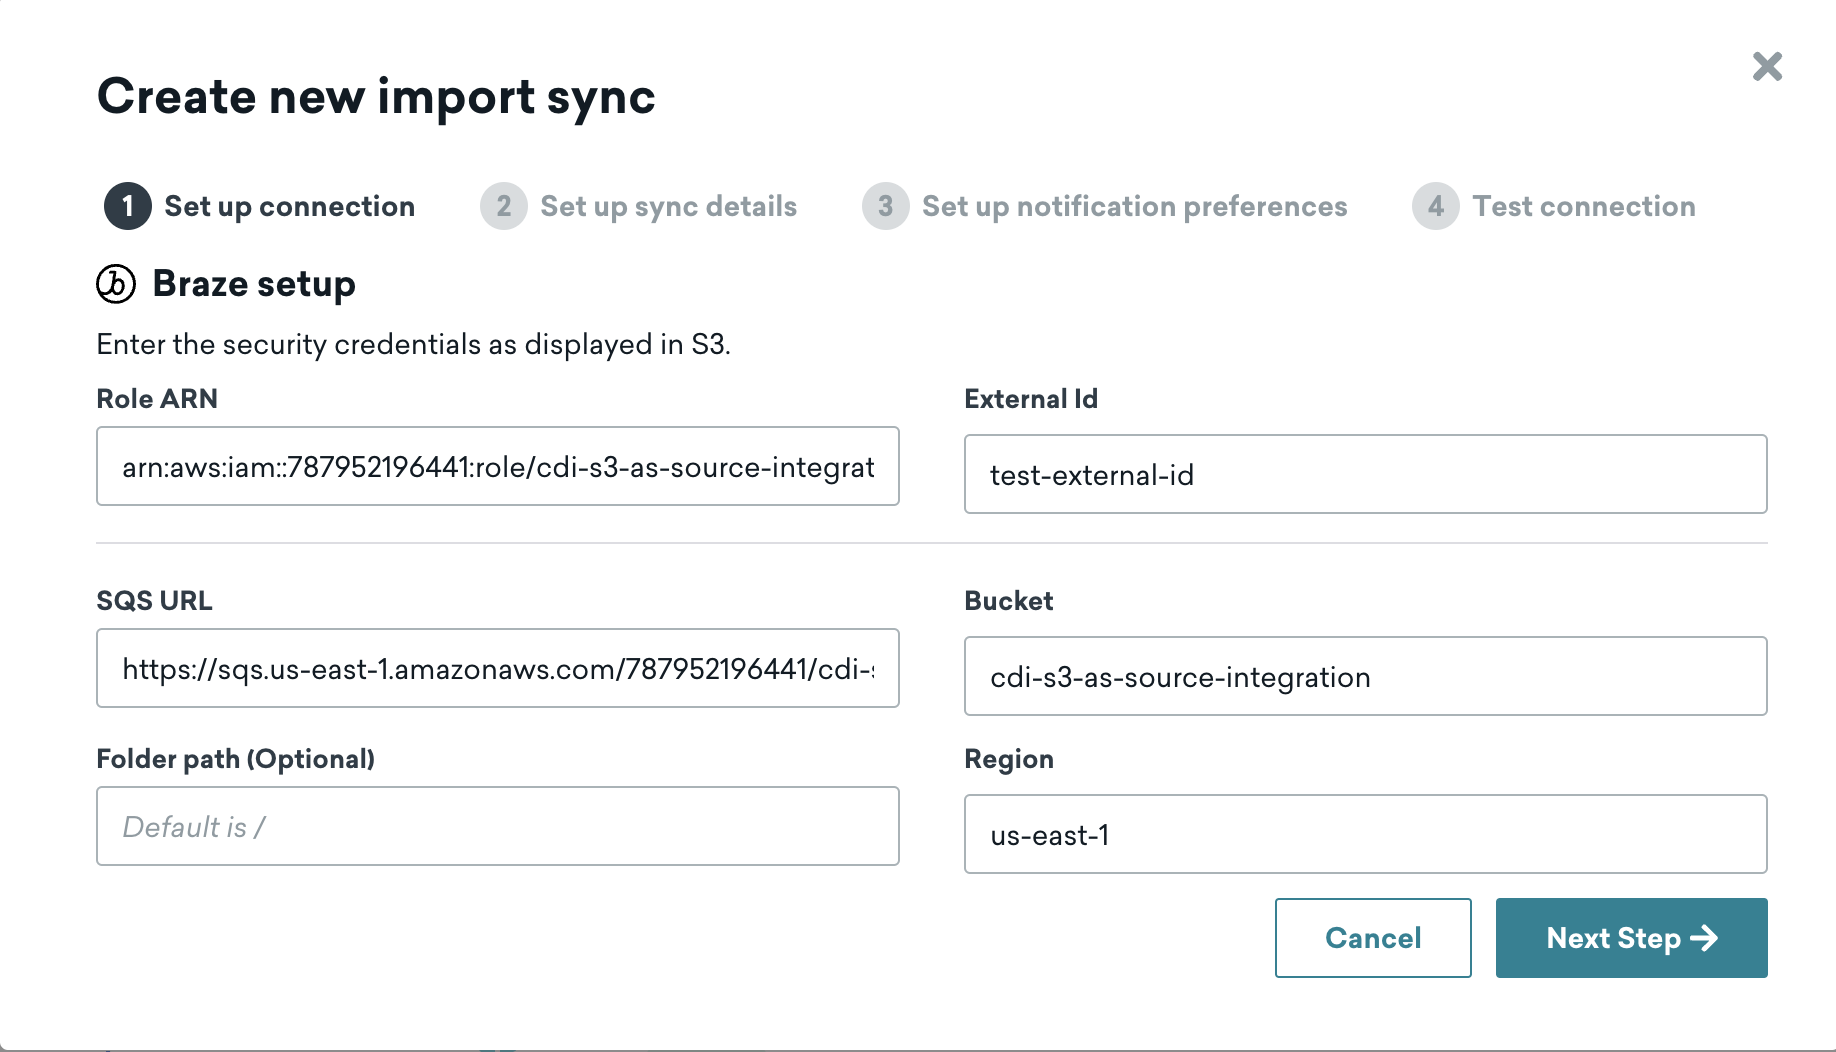
- Selecione Testar conexão para confirmar que a Braze consegue acessar seu bucket. Depois de um teste bem-sucedido, selecione Conectar à fonte. Se a conexão falhar, uma mensagem de erro aparecerá para ajudar a solucionar o problema.
- Em seguida, crie uma nova sincronização. Acesse Configurações de dados > Ingestão de dados na nuvem > Sincronizações e selecione Criar sincronização de dados.
- Escolha um nome para a sincronização. Depois, selecione qualquer fonte S3 ativa e insira a tabela de origem da sincronização. Selecione um tipo de dado e selecione Testar conexão.
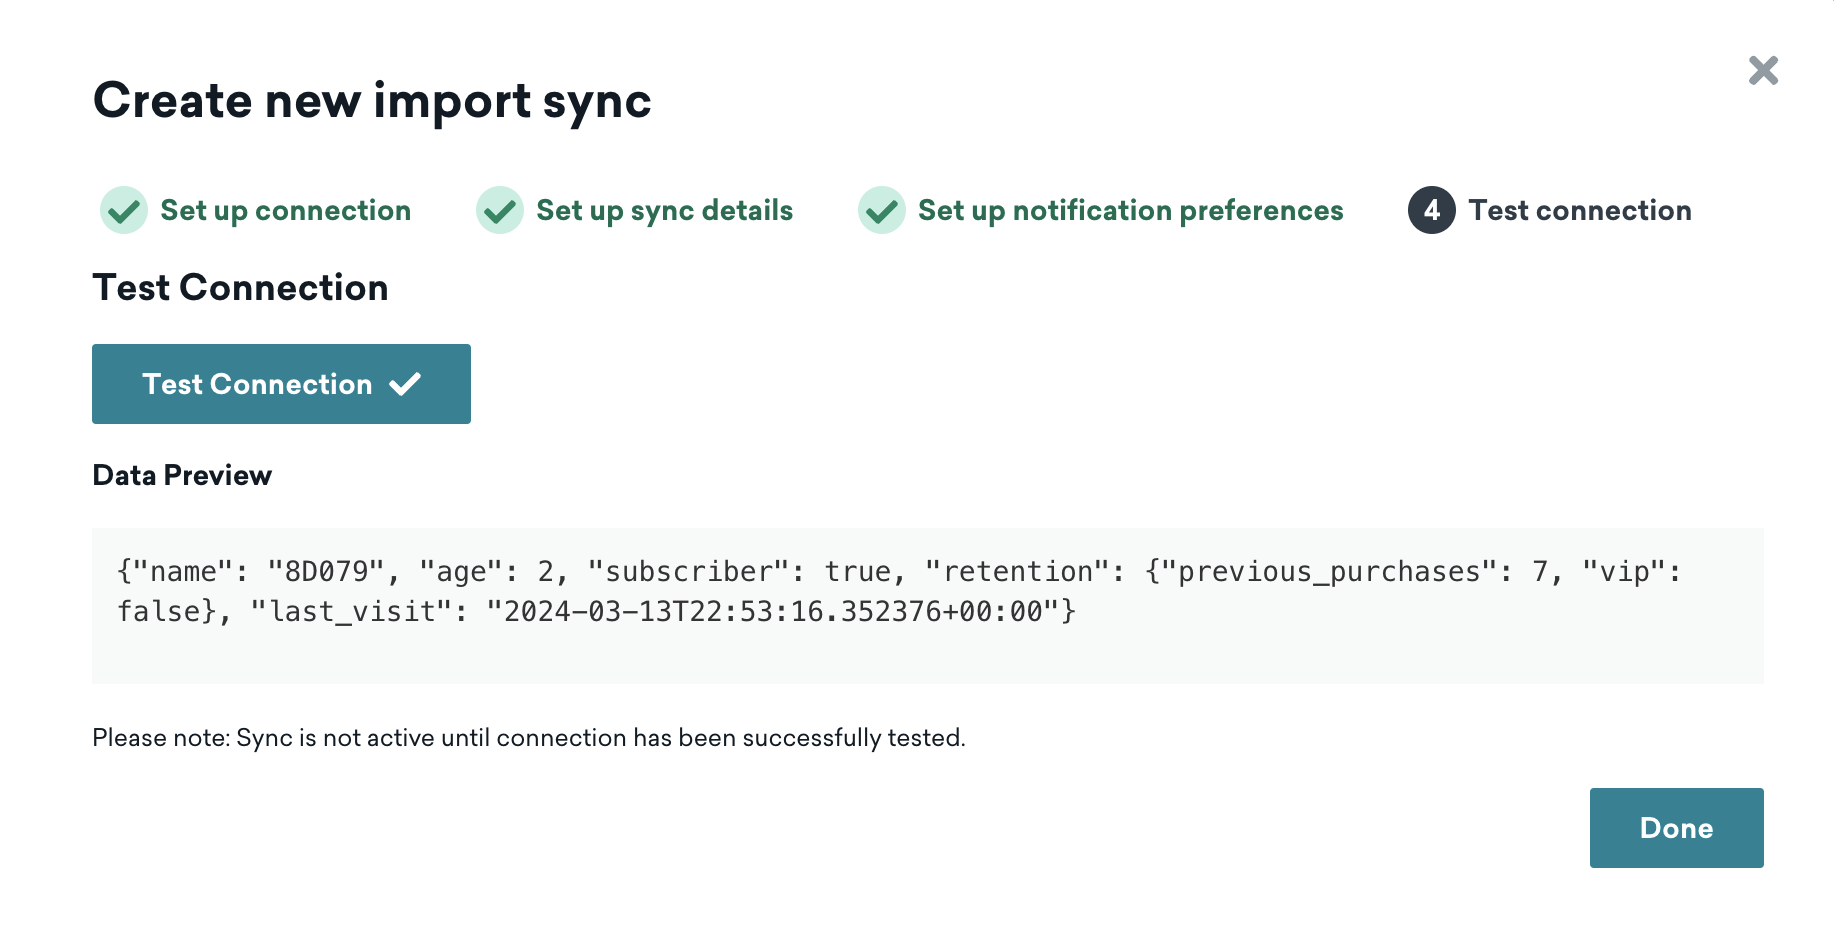
- Insira as informações restantes do processo de configuração da AWS. Especifique o seguinte:
- URL da fila SQS (precisa ser exclusiva para cada nova integração)
- Caminho da pasta (opcional, precisa ser exclusivo entre as sincronizações de um espaço de trabalho)
- Selecione um tipo de dado e selecione Testar conexão para confirmar que a Braze consegue listar os arquivos disponíveis para ingestão (não os dados dentro desses arquivos). Quando o teste for bem-sucedido, selecione Próximo: Notificações.
- Adicione endereços de e-mail de contato para receber notificações caso a sincronização falhe por problemas de acesso ou permissões. Se quiser, ative notificações para erros no nível do usuário e para sincronizações bem-sucedidas.
- Crie a sincronização.
Formatos de arquivo obrigatórios
A Ingestão de dados na nuvem aceita arquivos JSON, CSV e Parquet. As colunas obrigatórias variam conforme o tipo de dados. A Braze não impõe nenhum requisito de nome de arquivo além dos que o seu provedor de armazenamento de arquivos já exige. Os nomes de arquivo devem ser exclusivos, e adicionar um carimbo de data/hora ajuda a garantir isso.
Ao contrário das fontes de data warehouse, a coluna UPDATED_AT não é obrigatória nem compatível com sincronizações de armazenamento de arquivos.
Para ver exemplos de todos os tipos de arquivo aceitos, confira os arquivos de amostra em braze-examples.
Selecione a guia do tipo de dados que você quer sincronizar.
Cada linha precisa ter exatamente um identificador de usuário e uma coluna PAYLOAD. Um arquivo de origem pode ter linhas com tipos de identificador diferentes, mas cada linha deve usar apenas um.
| Identificador | Descrição |
|---|---|
EXTERNAL_ID |
Identifica o usuário que você quer atualizar. Deve corresponder ao valor external_id usado na Braze. |
ALIAS_NAME e ALIAS_LABEL |
Essas duas colunas criam um objeto de alias de usuário. alias_name deve ser um identificador exclusivo, e alias_label especifica o tipo de alias. Os usuários podem ter vários aliases com rótulos diferentes, mas apenas um alias_name por alias_label. |
BRAZE_ID |
O identificador de usuário da Braze. Ele é gerado pelo SDK da Braze, e não é possível criar novos usuários usando um ID da Braze pela Ingestão de dados na nuvem. Para criar novos usuários, especifique um ID de usuário externo ou um alias de usuário. |
EMAIL |
O endereço de e-mail do usuário. Se houver vários perfis com o mesmo endereço de e-mail, o perfil atualizado mais recentemente terá prioridade nas atualizações. Se você incluir e-mail e telefone, a Braze usará o e-mail como identificador principal. |
PHONE |
O número de telefone do usuário. Se houver vários perfis com o mesmo número de telefone, o perfil atualizado mais recentemente terá prioridade nas atualizações. |
A coluna PAYLOAD contém uma string JSON com os campos que você quer sincronizar com o usuário na Braze, seguindo o formato do objeto de atributos do usuário.
Exemplo de JSON
{"external_id":"s3-qa-0","payload":"{\"name\": \"GT896\", \"age\": 74, \"subscriber\": true, \"retention\": {\"previous_purchases\": 21, \"vip\": false}, \"last_visit\": \"2023-08-08T16:03:26.600803\"}"}
{"external_id":"s3-qa-1","payload":"{\"name\": \"HSCJC\", \"age\": 86, \"subscriber\": false, \"retention\": {\"previous_purchases\": 0, \"vip\": false}, \"last_visit\": \"2023-08-08T16:03:26.600824\"}"}
{"external_id":"s3-qa-2","payload":"{\"name\": \"YTMQZ\", \"age\": 43, \"subscriber\": false, \"retention\": {\"previous_purchases\": 23, \"vip\": true}, \"last_visit\": \"2023-08-08T16:03:26.600831\"}"}
Exemplo de CSV
external_id,payload
s3-qa-load-0-d0daa196-cdf5-4a69-84ae-4797303aee75,"{""name"": ""SNXIM"", ""age"": 54, ""subscriber"": true, ""retention"": {""previous_purchases"": 19, ""vip"": true}, ""last_visit"": ""2023-08-08T16:03:26.598806""}"
s3-qa-load-1-d0daa196-cdf5-4a69-84ae-4797303aee75,"{""name"": ""0J747"", ""age"": 73, ""subscriber"": false, ""retention"": {""previous_purchases"": 22, ""vip"": false}, ""last_visit"": ""2023-08-08T16:03:26.598816""}"
Todas as linhas do arquivo de origem devem conter JSON válido. Caso contrário, o arquivo será ignorado.
Os eventos personalizados usam as mesmas colunas de identificador de usuário que os atributos do usuário. A coluna PAYLOAD segue o formato do objeto de eventos.
{"external_id":"s3-qa-0","payload":"{\"app_id\": \"YOUR_APP_ID\", \"name\": \"view-206\", \"time\": \"2024-04-02T14:34:08\", \"properties\": {\"bool_value\": false, \"preceding_event\": \"unsubscribe\", \"important_number\": 206}}"}
{"external_id":"s3-qa-1","payload":"{\"app_id\": \"YOUR_APP_ID\", \"name\": \"view-206\", \"time\": \"2024-04-02T14:34:08\", \"properties\": {\"bool_value\": false, \"preceding_event\": \"unsubscribe\", \"important_number\": 206}}"}
Todas as linhas do arquivo de origem devem conter JSON válido. Caso contrário, o arquivo será ignorado.
Os eventos de compra usam as mesmas colunas de identificador de usuário que os atributos do usuário. A coluna PAYLOAD segue o formato do objeto de compras.
{"external_id":"s3-qa-0","payload":"{\"app_id\": \"YOUR_APP_ID\", \"product_id\": \"product-11\", \"currency\": \"BSD\", \"price\": 8.511527858335066, \"time\": \"2024-04-02T14:34:08\", \"quantity\": 19, \"properties\": {\"is_a_boolean\": true, \"important_number\": 40, \"preceding_event\": \"click\"}}"}
{"external_id":"s3-qa-1","payload":"{\"app_id\": \"YOUR_APP_ID\", \"product_id\": \"product-11\", \"currency\": \"BSD\", \"price\": 8.511527858335066, \"time\": \"2024-04-02T14:34:08\", \"quantity\": 19, \"properties\": {\"is_a_boolean\": true, \"important_number\": 40, \"preceding_event\": \"click\"}}"}
Todas as linhas do arquivo de origem devem conter JSON válido. Caso contrário, o arquivo será ignorado.
Os arquivos de catálogo usam identificadores diferentes dos arquivos de dados de usuários. Antes de criar uma sincronização de catálogo, crie o catálogo de destino na Braze. Para ver o fluxo de trabalho completo de catálogos, consulte Sincronizar e excluir dados de catálogo.
| Coluna | Obrigatório | Descrição |
|---|---|---|
ID |
Sim | O identificador exclusivo do item de catálogo. É usado para criar, atualizar ou excluir o item na Braze. |
PAYLOAD |
Sim | Uma string JSON com os campos e valores do catálogo a serem sincronizados. Deve corresponder ao esquema do seu catálogo na Braze. |
DELETED |
Não | Quando for true, o item de catálogo com o ID correspondente será removido do catálogo na Braze. Omita essa coluna ou defina-a como false para operações de criação ou atualização. |
Exemplo de JSON
{"id":"85","payload":"{\"product_name\":\"Product 85\",\"price\":85.85}"}
{"id":"86","payload":"{\"product_name\":\"Product 86\",\"price\":86.86}"}
{"id":"1","payload":"{\"product_name\":\"Product 1\",\"price\":1.01}","deleted":true}
Exemplo de CSV com a coluna DELETED
ID,PAYLOAD,DELETED
85,"{""product_name"": ""Product 85"", ""price"": 85.85}",false
86,"{""product_name"": ""Product 86"", ""price"": 86.86}",false
1,"{""product_name"": ""Product 1"", ""price"": 1.01}",true
Exemplo de CSV sem a coluna DELETED
ID,PAYLOAD
85,"{""product_name"": ""Product 85"", ""price"": 85.85}"
86,"{""product_name"": ""Product 86"", ""price"": 86.86}"
Os disparadores de Canvas viabilizam a personalização sem cópia de dados (zero-copy). Para ver a configuração do Canvas de destino e as considerações, consulte Personalização sem cópia de dados.
| Campo | Obrigatório | Descrição |
|---|---|---|
EXTERNAL_ID |
Sim, external_id ou alias_name e alias_label |
Identifica o usuário que você quer atualizar. Deve corresponder ao valor external_id usado na Braze. |
ALIAS_NAME e ALIAS_LABEL |
Sim, external_id ou alias_name e alias_label |
Essas duas colunas criam um objeto de alias de usuário. alias_name deve ser um identificador exclusivo, e alias_label especifica o tipo de alias. Os usuários podem ter vários aliases com rótulos diferentes, mas apenas um alias_name por alias_label. |
PROPERTIES |
Sim | String JSON com os campos que ficarão disponíveis como propriedades de personalização no seu Canvas. Deve conter informações específicas do usuário. |
Para começar, selecione o tipo de dados Disparadores de Canvas ao criar uma nova sincronização.
Para excluir perfis de usuário na Braze usando arquivos do seu bucket de origem:
- Crie uma nova sincronização de Ingestão de dados na nuvem, usando a mesma configuração das outras sincronizações.
- Ao configurar a sincronização na Braze, defina Tipo de dados como Excluir usuários.
- Faça upload de arquivos para o bucket de origem que contenham apenas colunas de identificador de usuário. Não inclua uma coluna
PAYLOAD. Para evitar exclusões acidentais, a sincronização falha se houver carga útil.
Cada linha do arquivo deve identificar exatamente um usuário usando um destes identificadores:
| Identificador | Descrição |
|---|---|
EXTERNAL_ID |
Corresponde ao external_id usado na Braze. |
ALIAS_NAME e ALIAS_LABEL |
As duas colunas juntas identificam o usuário pelo alias. |
BRAZE_ID |
ID do usuário gerado pela Braze (somente usuários existentes). |
Exemplo de JSON
{"external_id":"user-to-delete-001"}
{"external_id":"user-to-delete-002"}
{"braze_id":"braze-id-from-profile"}
Exemplo de CSV
external_id
user-to-delete-001
user-to-delete-002
Quando a sincronização é executada, a Braze processa os novos arquivos do bucket e exclui os perfis de usuário correspondentes.
A exclusão de usuários é permanente e não pode ser desfeita. Inclua apenas os usuários que você pretende remover. Para saber mais, consulte Excluir usuários com a Ingestão de dados na nuvem.
Excluir itens do catálogo
Para remover itens de um catálogo usando armazenamento de arquivos:
- Use a mesma sincronização que você usa para sincronizar dados do catálogo (tipo de dados Catálogos).
- Nos seus arquivos CSV ou JSON, adicione uma coluna opcional
deleted(ouDELETED). - Defina
deletedcomotruepara qualquer item que você queira remover do catálogo na Braze.
Cada linha ainda precisa de ID e PAYLOAD. Nas linhas marcadas para exclusão, a carga útil pode ser mínima, porque a Braze remove o item pelo ID.
Quando a sincronização é executada, as linhas com deleted: true fazem com que o item de catálogo correspondente seja excluído na Braze. Para saber mais sobre a sincronização completa do catálogo e o comportamento de exclusão, consulte Sincronizar e excluir dados do catálogo.
O que você precisa saber
- Os arquivos adicionados ao bucket ou contêiner de origem não devem exceder 512 MB. Esse limite se aplica ao Amazon S3, ao Google Cloud Storage e ao Azure Blob Storage. Arquivos maiores que 512 MB resultam em erro e não são sincronizados com a Braze. O próprio Azure Blob Storage permite arquivos muito maiores, mas a CDI aplica o mesmo limite de 512 MB a todas as fontes de armazenamento de arquivos.
- Embora não haja limite adicional para o número de linhas por arquivo, a Braze recomenda usar arquivos menores para acelerar suas sincronizações. Por exemplo, um arquivo de 500 MB levaria bem mais tempo para ser ingerido do que cinco arquivos separados de 100 MB.
- Não há limite adicional para o número de arquivos enviados em um determinado período.
- A ordenação não é suportada dentro dos arquivos nem entre eles. Se você estiver monitorando possíveis condições de corrida, a Braze recomenda atualizar os dados em lotes periodicamente.
- A CDI só processa arquivos adicionados depois que a sincronização é criada. Você pode usar arquivos existentes para validar se a Braze consegue acessar seu bucket e detectar os arquivos a serem ingeridos, mas eles não são sincronizados com a Braze. Para que a CDI processe esses arquivos, envie novamente ao bucket de origem todos os arquivos existentes que você quer sincronizar.
- A Braze só exclui uma mensagem do SQS quando o arquivo é lido com sucesso e as linhas resultantes são ingeridas nos sistemas internos da Braze. A Braze não estende o tempo limite de visibilidade. Se você estiver vendo mensagens na sua fila de mensagens não entregues (dead-letter queue), considere aumentar o tempo limite de visibilidade para corresponder ao tempo de processamento dos seus maiores arquivos. A Braze também rastreia metadados de cada arquivo: se um arquivo for ingerido com sucesso e uma mensagem duplicada do SQS aparecer para esse arquivo, a Braze exclui imediatamente a mensagem duplicada. Se o arquivo não tiver sido ingerido com sucesso, a Braze processa a mensagem do SQS normalmente.
Solução de problemas
Upload e processamento de arquivos
A CDI só processa arquivos adicionados depois que a sincronização é criada. Nesse processo, a Braze procura novos arquivos adicionados, o que dispara uma nova notificação. Isso inicia uma nova sincronização para processar o novo arquivo. No Amazon S3, a notificação é uma mensagem para o SQS.
Você pode usar arquivos existentes para validar se a Braze consegue acessar seu bucket e detectar arquivos para ingestão, mas eles não são sincronizados com a Braze. Para que a CDI processe esses arquivos, você precisa fazer upload novamente, no bucket de origem, de todos os arquivos existentes que deseja sincronizar.
Como lidar com erros inesperados de arquivo
Se você estiver observando um número alto de erros ou arquivos com falha, talvez outro processo esteja adicionando arquivos ao bucket S3 em uma pasta diferente da pasta de destino da CDI.
Quando arquivos são enviados para o bucket de origem, mas fora da pasta de origem, a CDI processa a notificação do SQS, mas não executa nenhuma ação no arquivo. Por isso, a situação pode aparecer como um erro.
Se o seu problema estiver relacionado às notificações do S3 ou às permissões de destino do SQS (por exemplo, erros de validação de destino), consulte a documentação da AWS:
- Ativar e configurar notificações de eventos usando o console do Amazon S3
- Conceder permissões para publicar mensagens de notificação de eventos em um destino
- Solução de problemas no Amazon SQS
Erro de objeto de integração incorreto
Esse erro ocorre quando dois ou mais espaços de trabalho têm integrações apontando para o mesmo bucket ou pasta de armazenamento em nuvem. Cada local de armazenamento em nuvem só pode ser usado por uma integração por vez. Para ver as etapas de resolução, consulte as perguntas frequentes.
Páginas relacionadas
- Configuração da tabela para colunas obrigatórias e formatação da carga útil
- Melhores práticas para agendamento de sincronizações e eficiência no uso de pontos de dados
- Logs de sincronização e observabilidade para monitorar as execuções de sincronização
- Perguntas frequentes para dúvidas comuns sobre todas as fontes