Ingestion de données cloud pour Azure Blob Storage
Cette page présente tout ce dont vous avez besoin pour synchroniser des données d’Azure Blob Storage vers Braze à l’aide de l’ingestion de données cloud (CDI) : les ressources Azure à créer, la connexion de la source et la création d’une synchronisation dans Braze, le format de fichier pour chaque type de données et la résolution des problèmes propres à Azure.
Fonctionnement
Les intégrations Azure Blob Storage sont déclenchées par des événements plutôt que planifiées. Lorsque de nouveaux fichiers sont créés dans le conteneur, un abonnement aux événements dans Azure Event Grid publie un événement Blob Created dans une file d’attente Azure Storage. Braze lit ensuite ces messages dans la file d’attente pour ingérer le nouveau fichier.
L’intégration nécessite les ressources suivantes :
- Un compte de stockage avec un conteneur blob pour le stockage des données
- Une file d’attente Azure Storage et un abonnement aux événements pour les notifications de nouveaux fichiers
- Un principal de service Microsoft Entra ID que CDI utilise pour lire le conteneur et la file d’attente
Définitions Azure
| Terme | Définition |
|---|---|
| Compte de stockage | Un compte de stockage est la ressource Azure de niveau supérieur qui contient à la fois le conteneur dans lequel CDI lit les fichiers et la file d’attente dans laquelle CDI lit les notifications. |
| Conteneur | Un conteneur héberge les fichiers de données que vous souhaitez faire ingérer par CDI. Les conteneurs se trouvent dans un compte de stockage. |
| File d’attente Azure Storage | Une file d’attente reçoit les notifications de nouveaux fichiers provenant de votre conteneur. CDI lit et acquitte les messages de cette file d’attente pour savoir quels fichiers ingérer. |
| Abonnement aux événements | Un abonnement aux événements achemine les événements de votre compte de stockage vers une destination à l’aide du service Azure Event Grid. Vous le configurez pour envoyer les événements Blob Created à votre file d’attente. |
| Rubrique système | Une rubrique système représente la source des événements. Event Grid en crée une pour votre compte de stockage lorsque vous ajoutez le premier abonnement aux événements. |
| Principal de service | Un principal de service est une identité Microsoft Entra ID sous laquelle CDI s’authentifie. Vous le créez via une inscription d’application et saisissez ses identifiants dans Braze. |
| Attribution de rôle Azure | Une attribution de rôle accorde à un principal de service un ensemble d’autorisations sur une étendue donnée. Vous attribuez trois rôles intégrés au principal de service de Braze sur votre compte de stockage. |
Configurer l’ingestion de données cloud dans Azure
Étape 1 : Créer un conteneur
Le conteneur et la file d’attente doivent se trouver dans le même compte de stockage. Vous pouvez réutiliser un compte de stockage existant. Si vous n’en avez pas encore, accédez à Storage accounts > + Create dans le portail Azure pour en créer un.
- Dans le portail Azure, accédez à votre compte de stockage, puis à Data storage > Containers.
- Sélectionnez + Add container et donnez-lui un nom.
Notez le nom du compte de stockage et celui du conteneur. Vous en aurez besoin lors de la configuration de la source dans Braze.
Étape 2 : Créer une file d’attente
- Dans le même compte de stockage, accédez à Data storage > Queues.
- Sélectionnez + Queue et donnez-lui un nom.
Notez le nom de la file d’attente. Vous en aurez besoin lors de la création de la synchronisation, et chaque synchronisation nécessite sa propre file d’attente.
Étape 3 : Créer un abonnement aux événements
Créez un abonnement aux événements pour que votre conteneur prévienne la file d’attente chaque fois qu’un fichier arrive.
- Dans le même compte de stockage, accédez à Events, puis sélectionnez + Event Subscription.
- Sous Event Subscription Details, saisissez un Name et définissez Event Schema sur Event Grid Schema.
- Sous Topic Details, vérifiez le System Topic Name. Si votre compte de stockage ne dispose pas encore de rubrique système, saisissez un nom pour en créer une. S’il en a déjà une, le champ affiche ce nom et ne peut pas être modifié. Tous les abonnements aux événements d’un compte de stockage utilisent la même rubrique système.
- Sous Event Types, définissez Filter to Event Types sur Blob Created uniquement. Blob Deleted est également sélectionné par défaut : décochez-le.
- Sous Endpoint Details, définissez Endpoint Type sur Storage Queue. Le lien Configure an endpoint apparaît une fois le type d’endpoint choisi.
- Sélectionnez Configure an endpoint, puis choisissez le compte de stockage dans lequel vous travaillez.
- Sélectionnez Select existing queue, puis choisissez la file d’attente créée à l’étape 2.
- Sélectionnez Select pour confirmer l’endpoint.
- Sélectionnez Create.
Étape 4 : Configurer l’authentification
CDI se connecte à votre compte de stockage avec la méthode d’authentification suivante :
| Méthode | Mode d’authentification de Braze | Informations à saisir dans Braze |
|---|---|---|
| Service principal | Braze authenticates as a Microsoft Entra ID service principal with a client secret. | Tenant ID, Principal ID, and Client Secret |
Service principal
CDI se connecte à votre compte de stockage à l’aide d’un principal de service avec l’authentification Microsoft Entra ID. Braze a besoin des informations suivantes pour se connecter :
- ID de locataire (également appelé répertoire) de votre compte Azure
- ID de principal (également appelé ID d’application) pour le principal de service
- Secret client pour permettre à Braze de s’authentifier
L’inscription d’une application nécessite l’autorisation de créer des inscriptions d’applications dans Microsoft Entra ID. Si vous ne disposez pas de cette autorisation, demandez à un administrateur Entra d’effectuer cette étape et de vous transmettre les identifiants.
- Dans le portail Azure, accédez au centre d’administration Microsoft Entra, puis à App Registrations.
- Sélectionnez + New registration sous Identity > Applications > App registrations.
- Saisissez un nom et sélectionnez
Accounts in this organizational directory onlycomme type de compte pris en charge. Ensuite, sélectionnez Register. - Sélectionnez l’application (principal de service) que vous venez de créer, puis accédez à Certificates & secrets > + New client secret.
- Saisissez une description pour le secret et définissez une période d’expiration. Ensuite, sélectionnez Add.
- Notez le secret client créé afin de l’utiliser lors de la configuration de Braze.
Azure ne permet pas de définir une expiration illimitée pour les secrets de principal de service. Pensez à actualiser les identifiants avant leur expiration afin de maintenir le flux de données vers Braze.
Nous vous recommandons de créer un principal de service utilisé uniquement pour CDI, afin que son accès reste limité au conteneur et à la file d’attente que vous synchronisez. Si vous en avez déjà configuré un pour une source Microsoft Fabric, vous pouvez le réutiliser, mais il aura alors accès aux deux. Dans tous les cas, il doit disposer des attributions de rôles décrites à l’étape suivante.
Étape 5 : Attribuer des autorisations au principal de service
CDI a uniquement besoin d’un accès suffisant pour lire vos fichiers et traiter les messages de la file d’attente. Attribuez ces trois rôles intégrés directement sur le compte de stockage, et non au niveau de l’abonnement ou du groupe de ressources, car les attributions de rôle sont héritées vers le bas. N’attribuez pas de rôles plus étendus tels que Storage Blob Data Contributor, Storage Account Contributor ou Owner, qui accordent des autorisations d’écriture et de gestion dont CDI ne se sert jamais.
- Accédez à votre compte de stockage, puis à Access Control (IAM).
- Sélectionnez Add > Add role assignment.
- Recherchez par son nom le principal de service créé à l’étape 4.
- Attribuez-lui les rôles intégrés suivants :
- Storage Blob Data Reader : permet à CDI de lire les fichiers de votre conteneur.
- Storage Queue Data Reader : permet à CDI de lire la file d’attente elle-même, afin de trouver la file d’attente indiquée dans la synchronisation et de vérifier ses propriétés.
- Storage Queue Data Message Processor : permet à CDI de consulter, récupérer et supprimer les messages de votre file d’attente.
Vous pouvez utiliser un rôle personnalisé à la place, à condition qu’il accorde uniquement l’accès en lecture aux blobs du conteneur, l’accès en lecture à la file d’attente, ainsi que la possibilité de recevoir et de supprimer des messages dans la file d’attente.
Si Add role assignment est grisé, votre compte ne peut pas attribuer de rôles sur ce compte de stockage. Cette opération nécessite un rôle tel que Owner ou User Access Administrator. Demandez à un administrateur Azure d’effectuer cette étape.
Configurer l’ingestion de données cloud dans Braze
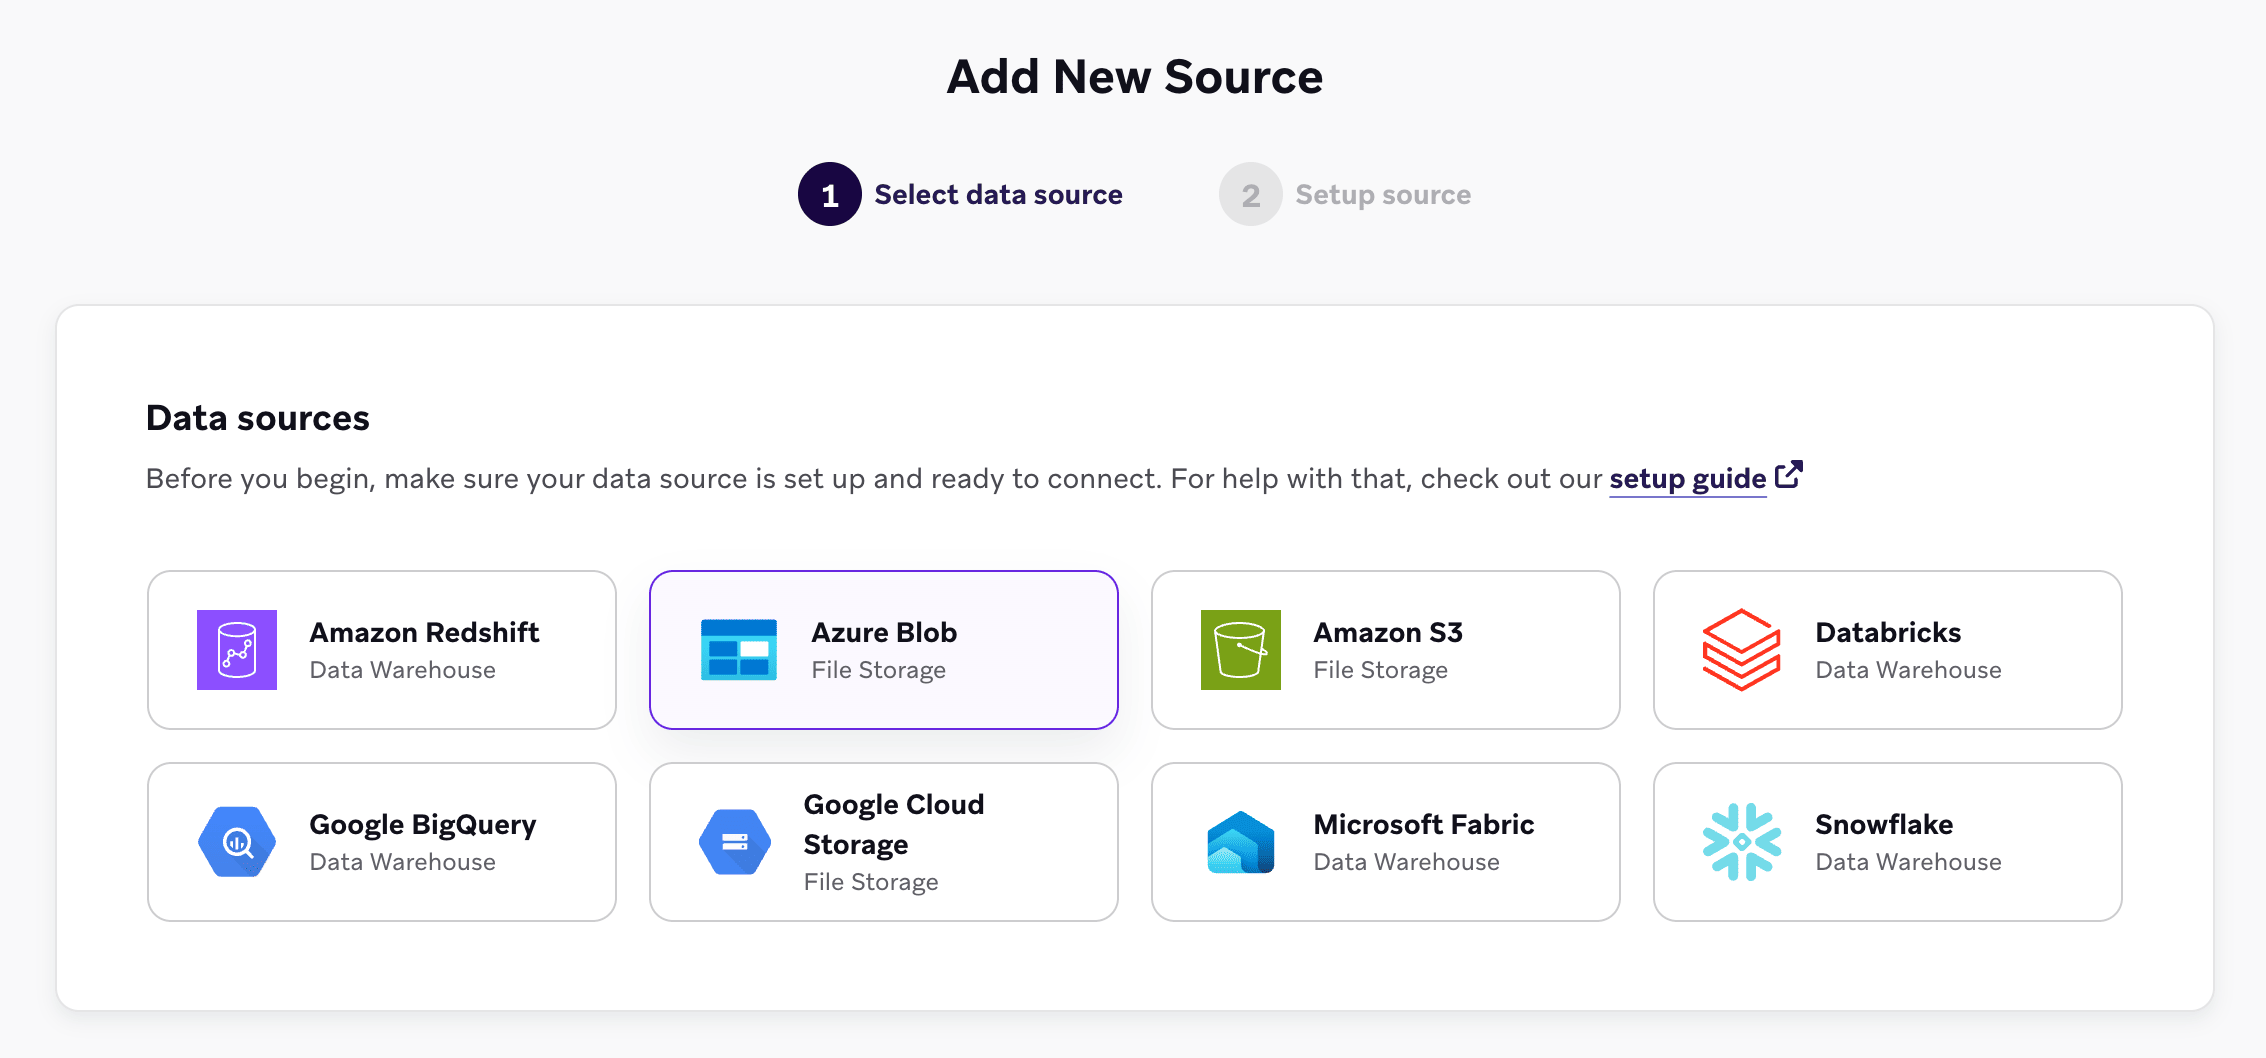
- Dans Braze, accédez à Paramètres des données > Ingestion de données cloud > Sources, sélectionnez Ajouter une source de données, puis Azure Blob.
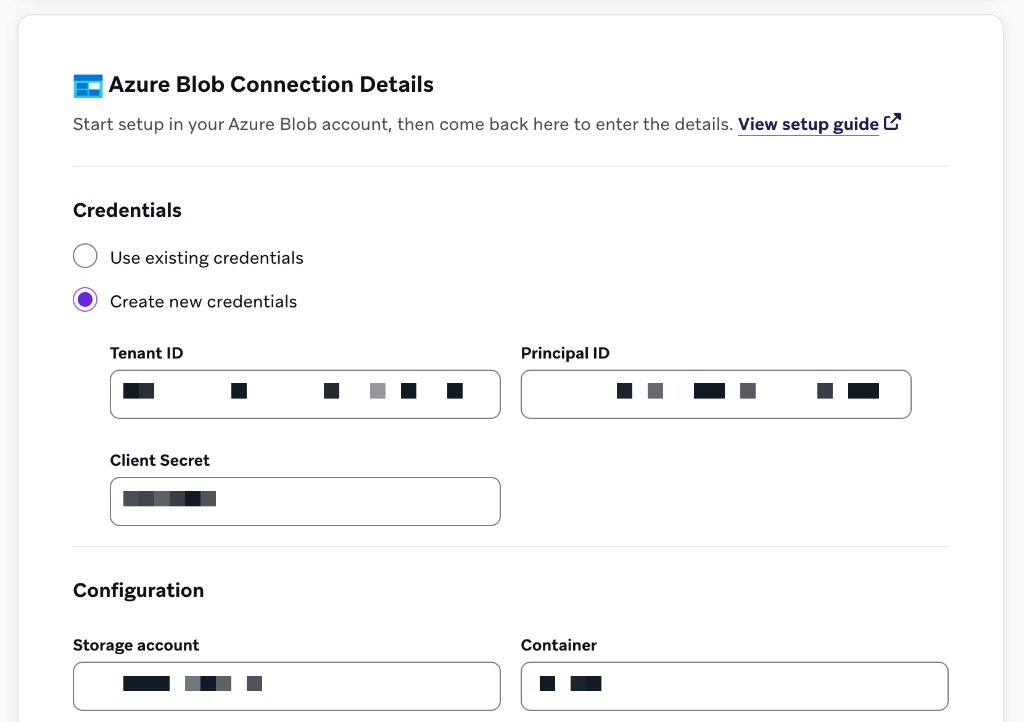
- Renseignez les champs Détails de connexion Azure Blob :
- Identifiants : les champs correspondant à la méthode d’authentification configurée à l’étape 4. Saisissez Tenant ID, Principal ID, and Client Secret.
- Configuration : Compte de stockage et Conteneur
- Sélectionnez Tester la connexion, puis Se connecter à la source.
- Créez une synchronisation. Accédez à Paramètres des données > Ingestion de données cloud > Synchronisations et sélectionnez Créer une synchronisation de données.
- Dans Configurations, choisissez un nom de synchronisation, sélectionnez votre source Azure Blob, puis un Type de données (par exemple Attributs utilisateur, Événements personnalisés, Événements d’achat, Catalogue ou Supprimer des utilisateurs).
- Dans Définition des données, indiquez les éléments suivants :
- Nom de la file d’attente de stockage : la file d’attente créée à l’étape 2. Chaque synchronisation nécessite sa propre file d’attente (voir Synchroniser un dossier dans un conteneur partagé).
- Chemin du dossier (facultatif) : un préfixe de chemin dans le conteneur
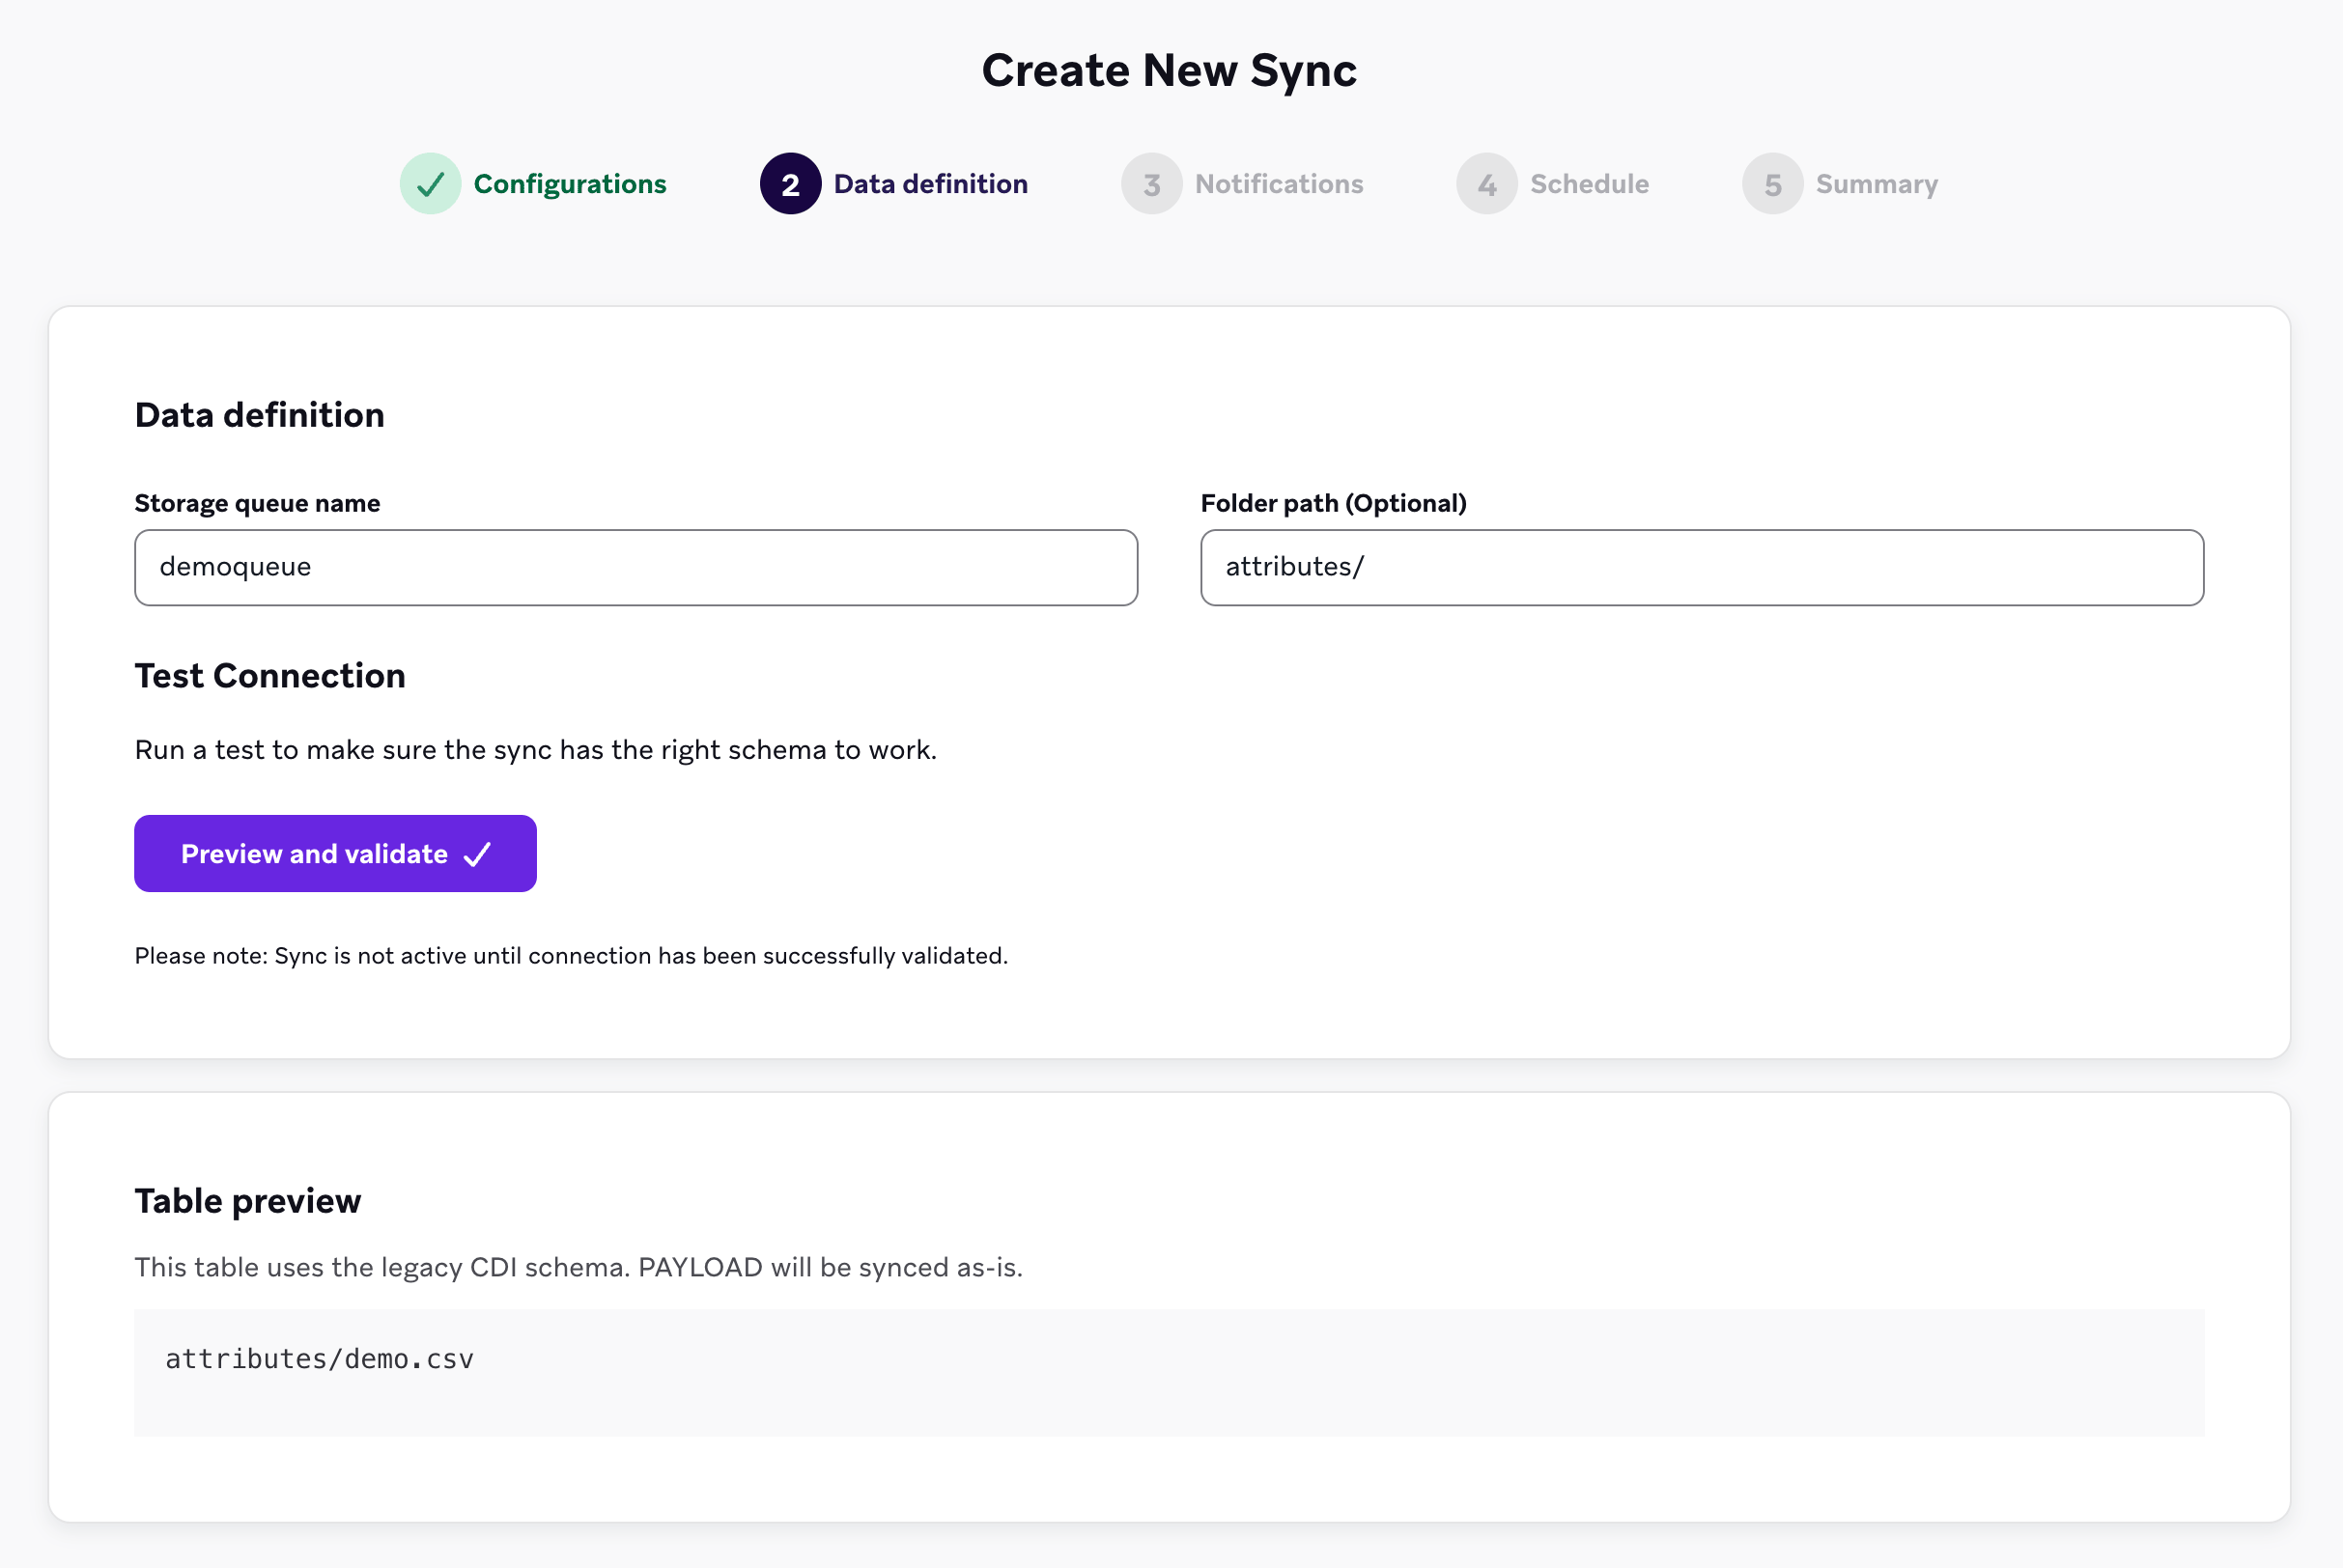
- Sélectionnez Prévisualiser et valider pour vérifier que CDI peut accéder à la file d’attente et lister les fichiers disponibles pour l’ingestion. Un test réussi liste les fichiers existants dans le conteneur, mais ces fichiers ne sont pas synchronisés automatiquement. La synchronisation n’est active qu’une fois la connexion validée.
- Dans Notifications, ajoutez les adresses e-mail des contacts à prévenir en cas d’erreur.
- Planification ne propose aucune option pour les synchronisations de stockage de fichiers. Les synchronisations Azure Blob Storage sont déclenchées par des événements : CDI ingère donc les nouveaux fichiers dès leur chargement.
- Vérifiez le Résumé, puis sélectionnez Créer une synchronisation.
Synchroniser un dossier dans un conteneur partagé
Vous pouvez réutiliser un même conteneur pour plusieurs synchronisations, mais chaque synchronisation nécessite sa propre file d’attente de stockage et son propre dossier.
Deux synchronisations ne peuvent pas utiliser la même file d’attente de stockage. Si vous saisissez une file d’attente déjà utilisée par une autre synchronisation, CDI le signale et affiche un lien vers la synchronisation existante.
Pour chaque dossier que vous souhaitez synchroniser dans un conteneur partagé :
- Créez une file d’attente pour ce dossier, comme à l’étape 2.
- Créez un abonnement aux événements qui envoie les événements Blob Created du conteneur vers cette file d’attente, comme à l’étape 3.
- Lors de la création de la synchronisation dans Braze, saisissez le Nom de la file d’attente de stockage de ce dossier et définissez Chemin du dossier (facultatif) sur le préfixe du dossier, par exemple
attributes/. CDI n’ingère que les fichiers dont le chemin commence par ce préfixe.
Formats de fichier requis
Cloud Data Ingestion prend en charge les fichiers JSON, CSV et Parquet. Les colonnes requises dépendent du type de données. Braze n’impose aucune exigence supplémentaire concernant les noms de fichiers, au-delà de celles de votre fournisseur de stockage de fichiers. Les noms de fichiers doivent être uniques, et l’ajout d’un horodatage permet de garantir cette unicité.
Contrairement aux sources d’entrepôt de données, la colonne UPDATED_AT n’est ni requise ni prise en charge pour les synchronisations de stockage de fichiers.
Pour consulter des exemples de tous les types de fichiers pris en charge, reportez-vous aux fichiers d’exemple dans braze-examples.
Sélectionnez l’onglet correspondant au type de données que vous souhaitez synchroniser.
Chaque ligne nécessite exactement un identifiant utilisateur et une colonne payload. Un fichier source peut contenir des lignes avec différents types d’identifiants, mais chaque ligne ne doit en utiliser qu’un seul.
| Identifiant | Description |
|---|---|
EXTERNAL_ID |
Identifie l’utilisateur que vous souhaitez mettre à jour. Cette valeur doit correspondre à la valeur external_id utilisée dans Braze. |
ALIAS_NAME et ALIAS_LABEL |
Ces deux colonnes créent un objet alias d’utilisateur. alias_name doit être un identifiant unique, et alias_label indique le type d’alias. Les utilisateurs peuvent avoir plusieurs alias avec des libellés différents, mais un seul alias_name par alias_label. |
BRAZE_ID |
L’identifiant utilisateur Braze. Il est généré par le SDK de Braze, et il n’est pas possible de créer de nouveaux utilisateurs à l’aide d’un ID Braze via Cloud Data Ingestion. Pour créer de nouveaux utilisateurs, indiquez un ID utilisateur externe ou un alias d’utilisateur. |
EMAIL |
L’adresse e-mail de l’utilisateur. Si plusieurs profils partagent la même adresse e-mail, le profil mis à jour le plus récemment est prioritaire pour les mises à jour. Si vous incluez à la fois l’e-mail et le téléphone, Braze utilise l’e-mail comme identifiant principal. |
PHONE |
Le numéro de téléphone de l’utilisateur. Si plusieurs profils partagent le même numéro de téléphone, le profil mis à jour le plus récemment est prioritaire pour les mises à jour. |
La colonne payload contient une chaîne de caractères JSON des champs que vous souhaitez synchroniser avec l’utilisateur dans Braze, selon le format de l’objet attributs utilisateur.
Exemple JSON
{"external_id":"s3-qa-0","payload":"{\"name\": \"GT896\", \"age\": 74, \"subscriber\": true, \"retention\": {\"previous_purchases\": 21, \"vip\": false}, \"last_visit\": \"2023-08-08T16:03:26.600803\"}"}
{"external_id":"s3-qa-1","payload":"{\"name\": \"HSCJC\", \"age\": 86, \"subscriber\": false, \"retention\": {\"previous_purchases\": 0, \"vip\": false}, \"last_visit\": \"2023-08-08T16:03:26.600824\"}"}
{"external_id":"s3-qa-2","payload":"{\"name\": \"YTMQZ\", \"age\": 43, \"subscriber\": false, \"retention\": {\"previous_purchases\": 23, \"vip\": true}, \"last_visit\": \"2023-08-08T16:03:26.600831\"}"}
Exemple CSV
external_id,payload
s3-qa-load-0-d0daa196-cdf5-4a69-84ae-4797303aee75,"{""name"": ""SNXIM"", ""age"": 54, ""subscriber"": true, ""retention"": {""previous_purchases"": 19, ""vip"": true}, ""last_visit"": ""2023-08-08T16:03:26.598806""}"
s3-qa-load-1-d0daa196-cdf5-4a69-84ae-4797303aee75,"{""name"": ""0J747"", ""age"": 73, ""subscriber"": false, ""retention"": {""previous_purchases"": 22, ""vip"": false}, ""last_visit"": ""2023-08-08T16:03:26.598816""}"
Chaque ligne de votre fichier source doit contenir du JSON valide, sinon le fichier est ignoré.
Les événements personnalisés utilisent les mêmes colonnes d’identifiant utilisateur que les attributs utilisateur. La colonne payload suit le format de l’objet événements.
{"external_id":"s3-qa-0","payload":"{\"app_id\": \"YOUR_APP_ID\", \"name\": \"view-206\", \"time\": \"2024-04-02T14:34:08\", \"properties\": {\"bool_value\": false, \"preceding_event\": \"unsubscribe\", \"important_number\": 206}}"}
{"external_id":"s3-qa-1","payload":"{\"app_id\": \"YOUR_APP_ID\", \"name\": \"view-206\", \"time\": \"2024-04-02T14:34:08\", \"properties\": {\"bool_value\": false, \"preceding_event\": \"unsubscribe\", \"important_number\": 206}}"}
Chaque ligne de votre fichier source doit contenir du JSON valide, sinon le fichier est ignoré.
Les événements d’achat utilisent les mêmes colonnes d’identifiant utilisateur que les attributs utilisateur. La colonne payload suit le format de l’objet achats.
{"external_id":"s3-qa-0","payload":"{\"app_id\": \"YOUR_APP_ID\", \"product_id\": \"product-11\", \"currency\": \"BSD\", \"price\": 8.511527858335066, \"time\": \"2024-04-02T14:34:08\", \"quantity\": 19, \"properties\": {\"is_a_boolean\": true, \"important_number\": 40, \"preceding_event\": \"click\"}}"}
{"external_id":"s3-qa-1","payload":"{\"app_id\": \"YOUR_APP_ID\", \"product_id\": \"product-11\", \"currency\": \"BSD\", \"price\": 8.511527858335066, \"time\": \"2024-04-02T14:34:08\", \"quantity\": 19, \"properties\": {\"is_a_boolean\": true, \"important_number\": 40, \"preceding_event\": \"click\"}}"}
Chaque ligne de votre fichier source doit contenir du JSON valide, sinon le fichier est ignoré.
Les fichiers de catalogue utilisent des identifiants différents de ceux des fichiers de données utilisateur. Avant de créer une synchronisation de catalogue, créez le catalogue cible dans Braze. Pour connaître le processus complet relatif aux catalogues, consultez Synchroniser et supprimer des données de catalogue.
| Colonne | Requis | Description |
|---|---|---|
ID |
Oui | L’identifiant unique de l’article de catalogue. Il sert à créer, mettre à jour ou supprimer l’article dans Braze. |
payload |
Oui | Une chaîne de caractères JSON des champs et valeurs de catalogue à synchroniser. Elle doit correspondre au schéma de votre catalogue dans Braze. |
DELETED |
Non | Lorsque la valeur est true, l’article de catalogue correspondant à l’ID est retiré du catalogue dans Braze. Omettez cette colonne ou définissez-la sur false pour les opérations de création ou de mise à jour. |
Exemple JSON
{"id":"85","payload":"{\"product_name\":\"Product 85\",\"price\":85.85}"}
{"id":"86","payload":"{\"product_name\":\"Product 86\",\"price\":86.86}"}
{"id":"1","payload":"{\"product_name\":\"Product 1\",\"price\":1.01}","deleted":true}
Exemple CSV avec la colonne DELETED
ID,PAYLOAD,DELETED
85,"{""product_name"": ""Product 85"", ""price"": 85.85}",false
86,"{""product_name"": ""Product 86"", ""price"": 86.86}",false
1,"{""product_name"": ""Product 1"", ""price"": 1.01}",true
Exemple CSV sans la colonne DELETED
ID,PAYLOAD
85,"{""product_name"": ""Product 85"", ""price"": 85.85}"
86,"{""product_name"": ""Product 86"", ""price"": 86.86}"
Les déclencheurs Canvas alimentent la personnalisation zéro copie. Pour la configuration du Canvas de destination et les points à prendre en compte, consultez Personnalisation zéro copie.
| Champ | Requis | Description |
|---|---|---|
EXTERNAL_ID |
Oui, l’un des deux : external_id ou alias_name et alias_label |
Identifie l’utilisateur que vous souhaitez mettre à jour. Cette valeur doit correspondre à la valeur external_id utilisée dans Braze. |
ALIAS_NAME et ALIAS_LABEL |
Oui, l’un des deux : external_id ou alias_name et alias_label |
Ces deux colonnes créent un objet alias d’utilisateur. alias_name doit être un identifiant unique, et alias_label indique le type d’alias. Les utilisateurs peuvent avoir plusieurs alias avec des libellés différents, mais un seul alias_name par alias_label. |
PROPERTIES |
Oui | Chaîne de caractères JSON des champs à rendre disponibles en tant que propriétés de personnalisation dans votre Canvas. Elle doit contenir des informations propres à l’utilisateur. |
Pour commencer, sélectionnez le type de données Déclencheurs Canvas lors de la création d’une nouvelle synchronisation.
Pour supprimer des profils utilisateur dans Braze à l’aide de fichiers présents dans votre compartiment source :
- Créez une nouvelle synchronisation Cloud Data Ingestion, avec la même configuration que pour les autres synchronisations.
- Lors de la configuration de la synchronisation dans Braze, définissez Type de données sur Supprimer des utilisateurs.
- Importez dans votre compartiment source des fichiers contenant uniquement des colonnes d’identifiant utilisateur. N’incluez pas de colonne
payload: la synchronisation échoue si un payload est présent, afin d’éviter les suppressions accidentelles.
Chaque ligne du fichier doit identifier exactement un utilisateur à l’aide de l’un des identifiants suivants :
| Identifiant | Description |
|---|---|
EXTERNAL_ID |
Correspond à l’external_id utilisé dans Braze. |
ALIAS_NAME et ALIAS_LABEL |
Ces deux colonnes identifient ensemble l’utilisateur par son alias. |
BRAZE_ID |
ID utilisateur généré par Braze (utilisateurs existants uniquement). |
Exemple JSON
{"external_id":"user-to-delete-001"}
{"external_id":"user-to-delete-002"}
{"braze_id":"braze-id-from-profile"}
Exemple CSV
external_id
user-to-delete-001
user-to-delete-002
Lors de l’exécution de la synchronisation, Braze traite les nouveaux fichiers du compartiment et supprime les profils utilisateur correspondants.
La suppression d’utilisateurs est définitive et irréversible. N’incluez que les utilisateurs que vous souhaitez réellement supprimer. Pour en savoir plus, consultez Supprimer des utilisateurs avec Cloud Data Ingestion.
Supprimer des éléments de catalogue
Pour supprimer des articles d’un catalogue à l’aide du stockage de fichiers :
- Utilisez la synchronisation que vous employez déjà pour synchroniser les données du catalogue (type de données Catalogues).
- Dans vos fichiers CSV ou JSON, ajoutez une colonne facultative
deleted(ouDELETED). - Définissez
deletedsurtruepour chaque article que vous souhaitez supprimer du catalogue dans Braze.
Chaque ligne doit toujours contenir ID et payload. Pour les lignes à supprimer, le payload peut être minimal : Braze supprime l’article en fonction de son ID.
Lors de l’exécution de la synchronisation, chaque ligne avec deleted: true entraîne la suppression de l’article de catalogue correspondant dans Braze. Pour en savoir plus sur le fonctionnement complet de la synchronisation et de la suppression des catalogues, consultez Synchroniser et supprimer des données de catalogue.
À savoir
- Les fichiers ajoutés au compartiment ou au conteneur source ne doivent pas dépasser 512 Mo. Cette limite s’applique à Amazon S3, Google Cloud Storage et Azure Blob Storage. Les fichiers de plus de 512 Mo génèrent une erreur et ne sont pas synchronisés avec Braze. Azure Blob Storage accepte en soi des fichiers beaucoup plus volumineux, mais CDI applique la même limite de 512 Mo à toutes les sources de stockage de fichiers.
- Bien qu’il n’y ait pas de limite supplémentaire sur le nombre de lignes par fichier, Braze recommande d’utiliser des fichiers plus petits pour accélérer vos synchronisations. Par exemple, l’ingestion d’un fichier de 500 Mo prendrait beaucoup plus de temps que celle de cinq fichiers distincts de 100 Mo.
- Il n’y a pas de limite supplémentaire sur le nombre de fichiers importés sur une période donnée.
- L’ordre n’est pas garanti au sein des fichiers ni entre eux. Si vous surveillez d’éventuelles conditions de concurrence, Braze recommande de regrouper périodiquement les mises à jour.
- CDI ne traite que les fichiers ajoutés après la création de la synchronisation. Vous pouvez utiliser des fichiers existants pour vérifier que Braze peut accéder à votre compartiment et détecter les fichiers à ingérer, mais ils ne sont pas synchronisés avec Braze. Pour que CDI les traite, importez à nouveau dans le compartiment source les fichiers existants que vous souhaitez synchroniser.
Résolution des problèmes
Chargement et traitement des fichiers
CDI traite uniquement les fichiers chargés après la création de la synchronisation. Chaque nouveau blob déclenche un événement Blob Created vers votre file d’attente. Pour ingérer des fichiers déjà présents dans le conteneur, chargez-les à nouveau.
Gérer les erreurs de fichiers inattendues
Si des fichiers ne sont pas ingérés, vérifiez les points suivants :
- L’abonnement aux événements existe sur le compte de stockage et est filtré sur Blob Created.
- L’abonnement aux événements utilise Event Grid Schema. CDI ne peut pas lire les événements fournis dans un autre schéma.
- L’endpoint de l’abonnement aux événements pointe vers la file d’attente configurée dans la synchronisation, et non vers une autre file d’attente.
- Le principal de service de Braze dispose des rôles Storage Blob Data Reader, Storage Queue Data Reader et Storage Queue Data Message Processor sur le compte de stockage.
- Le secret client du principal de service n’a pas expiré. Azure impose une date d’expiration aux secrets client, et un secret expiré interrompt la synchronisation.
Pour en savoir plus, consultez Azure Blob Storage en tant que source Event Grid dans la documentation Microsoft.
Erreur « Incorrect Integration Object »
Cette erreur se produit lorsque deux espaces de travail ou plus disposent d’intégrations pointant vers le même compartiment ou dossier de stockage cloud. Chaque emplacement de stockage cloud ne peut être utilisé que par une seule intégration à la fois. Pour connaître la marche à suivre, consultez la FAQ.
Pages connexes
- Configuration de la table pour connaître les colonnes requises et le formatage du payload
- Bonnes pratiques pour la planification des synchronisations et l’utilisation efficace des points de données
- Journaux de synchronisation et observabilité pour surveiller les exécutions de synchronisation
- FAQ pour les questions fréquentes communes à toutes les sources