Intégrations d’entrepôts de données
Cette page explique comment utiliser l’ingestion de données cloud (CDI) de Braze pour synchroniser des données pertinentes avec votre intégration Snowflake, Redshift, BigQuery et Databricks.
Configuration des intégrations d’entrepôts de données
Les intégrations Cloud Data Ingestion demandent une configuration côté Braze et dans votre instance d’entrepôt de données. Suivez ces étapes pour configurer l’intégration :
- Dans votre instance Snowflake, configurez les tables ou les vues à synchroniser avec Braze.
- Créez un rôle et un entrepôt, ainsi qu’un utilisateur que Braze authentifie avec Workload Identity Federation ou une paire de clés RSA.
- Créez une nouvelle source Snowflake dans le tableau de bord de Braze. Pour une paire de clés, ajoutez à l’utilisateur Snowflake la clé publique fournie par Braze. Pour Workload Identity Federation, exécutez l’instruction du formulaire d’identifiants dans une feuille de calcul Snowflake.
- Créez une synchronisation dans le tableau de bord de Braze, testez l’intégration, puis lancez la synchronisation.
Le guide de démarrage rapide de Snowflake fournit un exemple de code et présente les étapes nécessaires pour créer un pipeline automatisé à l’aide de Snowflake Streams et de CDI afin de synchroniser les données avec Braze.
- Assurez-vous que Braze peut accéder aux tables Redshift à synchroniser. Braze se connecte à Redshift via Internet.
- Dans votre instance Redshift, configurez les tables ou les vues à synchroniser avec Braze.
- Créez une nouvelle source et une synchronisation dans le tableau de bord de Braze.
- Testez l’intégration et lancez la synchronisation.
Le nombre de lignes traitées par synchronisation dépend des performances de votre entrepôt, de la latence du réseau et du volume de nouvelles données correspondant à la requête de synchronisation. Consultez l’Historique de synchronisation de l’intégration dans le tableau de bord pour voir la durée et le nombre de lignes des exécutions récentes.
- Créez un compte de service auquel Braze accède via Workload Identity Federation ou une clé de compte de service, et autorisez l’accès aux projets et jeux de données BigQuery contenant les données à synchroniser.
- Dans votre compte BigQuery, configurez les tables ou les vues à synchroniser avec Braze.
- Créez une nouvelle source et une synchronisation dans le tableau de bord de Braze.
- Testez l’intégration et lancez la synchronisation.
- Créez un principal de service pour l’authentification OAuth de machine à machine (M2M) ou un jeton d’accès personnel, et autorisez l’accès aux catalogues et schémas Databricks contenant les données à synchroniser.
- Dans votre compte Databricks, configurez les tables ou les vues à synchroniser avec Braze.
- Créez une nouvelle source et une synchronisation dans le tableau de bord de Braze.
- Testez l’intégration et lancez la synchronisation.
Un temps de démarrage de deux à cinq minutes peut être nécessaire lorsque Braze se connecte à des instances SQL Classic et Pro, ce qui peut entraîner des retards lors de la configuration et du test de la connexion, ainsi qu’au début des synchronisations planifiées. L’utilisation d’une instance SQL serverless réduit le temps de démarrage et améliore le débit des requêtes, mais peut entraîner des coûts d’intégration légèrement plus élevés.
- Créez un principal de service et accordez-lui l’accès aux API Fabric.
- Configurez un espace de travail partagé et accordez-y l’accès au principal de service.
- Dans l’espace de travail Fabric partagé, configurez les tables ou les vues à synchroniser avec Braze.
- Créez une nouvelle source et une synchronisation dans le tableau de bord de Braze.
- Testez l’intégration et lancez la synchronisation.
Étape 1 : Configurer les tables ou les vues
Les étapes de cette section créent une table avec une colonne payload. Si vous prévoyez de mapper des colonnes avec Visuel ou d’écrire une requête avec SQL à l’étape Définition des données, vous pouvez utiliser une table ou une vue existante. Ignorez l’étape de création de table pour votre entrepôt et accordez à Braze un accès en lecture aux tables ou vues à synchroniser. Pour comparer les options, consultez Choisir une option de définition des données.
Si vous utilisez une colonne payload, votre table ou vue source peut contenir des colonnes qui ne figurent pas dans les onglets de votre entrepôt dans la section suivante (par exemple, pour l’audit ou le hachage). Braze lit uniquement les colonnes décrites dans ces onglets ; les autres colonnes ne sont pas utilisées lors des synchronisations Cloud Data Ingestion.
Étape 1.1 : Configurer la table
CREATE DATABASE BRAZE_CLOUD_PRODUCTION;
CREATE SCHEMA BRAZE_CLOUD_PRODUCTION.INGESTION;
CREATE OR REPLACE TABLE BRAZE_CLOUD_PRODUCTION.INGESTION.USERS_ATTRIBUTES_SYNC (
UPDATED_AT TIMESTAMP_NTZ(9) NOT NULL DEFAULT SYSDATE(),
--at least one of external_id, alias_name and alias_label, email, phone, or braze_id is required
EXTERNAL_ID VARCHAR(16777216),
--if using user alias, both alias_name and alias_label are required
ALIAS_LABEL VARCHAR(16777216),
ALIAS_NAME VARCHAR(16777216),
--braze_id can only be used to update existing users created through the Braze SDK
BRAZE_ID VARCHAR(16777216),
--If you include both email and phone, email is used as the primary identifier
EMAIL VARCHAR(16777216),
PHONE VARCHAR(16777216),
PAYLOAD VARCHAR(16777216) NOT NULL
);
Vous pouvez nommer la base de données, le schéma et la table comme vous le souhaitez, mais les noms des colonnes doivent correspondre à la définition précédente.
UPDATED_AT- Moment où cette ligne a été mise à jour dans la table ou ajoutée à celle-ci. Braze synchronise les lignes dont la valeurUPDATED_ATest postérieure à la dernière valeur synchronisée. Les lignes dont l’horodatage correspond exactement à la limite peuvent être synchronisées de nouveau si de nouvelles lignes partagent ce même horodatage.- Colonnes d’identifiant utilisateur - Votre table peut contenir une ou plusieurs colonnes d’identifiant utilisateur. Chaque ligne ne doit contenir qu’un seul identifiant (soit
external_id, soit la combinaison dealias_nameetalias_label, soitbraze_id,emailouphone). Une table source peut comporter des colonnes pour un, deux, trois, quatre ou les cinq types d’identifiants.EXTERNAL_ID- Identifie l’utilisateur à mettre à jour. Cette valeur doit correspondre à la valeurexternal_idutilisée dans Braze.ALIAS_NAMEetALIAS_LABEL- Ces deux colonnes créent un objet alias d’utilisateur.alias_namedoit être un identifiant unique, etalias_labelprécise le type d’alias. Les utilisateurs peuvent avoir plusieurs alias avec des libellés différents, mais un seulalias_nameparalias_label.BRAZE_ID- Identifiant utilisateur Braze. Il est généré par le SDK de Braze, et il est impossible de créer de nouveaux utilisateurs à partir d’un ID Braze via Cloud Data Ingestion. Pour créer de nouveaux utilisateurs, indiquez un ID utilisateur externe ou un alias d’utilisateur.EMAIL- Adresse e-mail de l’utilisateur. S’il existe plusieurs profils avec la même adresse e-mail, le profil mis à jour le plus récemment est prioritaire pour les mises à jour. Si vous incluez à la fois l’e-mail et le téléphone, l’e-mail sert d’identifiant principal.PHONE- Numéro de téléphone de l’utilisateur. S’il existe plusieurs profils avec le même numéro de téléphone, le profil mis à jour le plus récemment est prioritaire pour les mises à jour.
payload- Chaîne de caractères JSON contenant les champs à synchroniser avec l’utilisateur dans Braze.
Étape 1.2 : Configurer le rôle et les autorisations de la base de données
CREATE ROLE BRAZE_INGESTION_ROLE;
GRANT USAGE ON DATABASE BRAZE_CLOUD_PRODUCTION TO ROLE BRAZE_INGESTION_ROLE;
GRANT USAGE ON SCHEMA BRAZE_CLOUD_PRODUCTION.INGESTION TO ROLE BRAZE_INGESTION_ROLE;
GRANT SELECT ON TABLE BRAZE_CLOUD_PRODUCTION.INGESTION.USERS_ATTRIBUTES_SYNC TO ROLE BRAZE_INGESTION_ROLE;
Modifiez les noms si nécessaire, mais les autorisations doivent correspondre à l’exemple précédent.
Étape 1.3 : Configurer l’entrepôt et donner accès au rôle Braze
CREATE WAREHOUSE BRAZE_INGESTION_WAREHOUSE;
GRANT USAGE ON WAREHOUSE BRAZE_INGESTION_WAREHOUSE TO ROLE BRAZE_INGESTION_ROLE;
L’indicateur auto-resume doit être activé sur l’entrepôt. Sinon, accordez à Braze des privilèges OPERATE supplémentaires sur l’entrepôt afin que Braze puisse l’activer lors de l’exécution de la requête.
Étape 1.4 : Configurer l’utilisateur
Braze s’authentifie auprès de Snowflake avec l’une des méthodes suivantes :
- Workload Identity Federation : Braze se connecte en tant qu’utilisateur
TYPE = SERVICElié à l’identité AWS de Braze pour Snowflake. L’utilisateur n’a ni mot de passe ni clé RSA. - Paire de clés : Braze se connecte avec une paire de clés RSA. Vous ajoutez à l’utilisateur Snowflake la clé publique générée par Braze.
Les identifiants existants par paire de clés RSA continuent de fonctionner, et vous n’avez pas besoin de les migrer. Choisissez une seule méthode.
Créez le rôle, l’entrepôt et les autorisations de base de données décrits aux étapes 1.2 et 1.3. Si votre compte Snowflake utilise une politique réseau, autorisez les adresses IP de Braze comme indiqué à l’étape 1.5.
Créez l’utilisateur de service à partir du formulaire d’identifiants Snowflake, puis exécutez cette instruction dans une feuille de calcul Snowflake. Pour savoir ce que fait l’instruction et où l’exécuter, consultez Configurer Snowflake pour Workload Identity Federation.
CREATE USER BRAZE_INGESTION_USER;
GRANT ROLE BRAZE_INGESTION_ROLE TO USER BRAZE_INGESTION_USER;
Après cette étape, partagez les informations de connexion avec Braze et ajoutez la clé publique à l’utilisateur.
Lorsque vous connectez différents espaces de travail au même compte Snowflake, vous devez créer un utilisateur unique pour chaque espace de travail Braze dans lequel vous créez une intégration. Au sein d’un espace de travail, vous pouvez réutiliser le même utilisateur pour plusieurs intégrations, mais la création de l’intégration échoue si un utilisateur du même compte Snowflake est dupliqué entre plusieurs espaces de travail.
Étape 1.5 : Autoriser les adresses IP de Braze dans la politique réseau de Snowflake (facultatif)
Selon la configuration de votre compte Snowflake, vous devrez peut-être autoriser les adresses IP suivantes dans votre politique réseau Snowflake. Pour plus d’informations sur cette opération, consultez la documentation de Snowflake sur la modification d’une politique réseau.
Pour les instances US-01, US-02, US-03, US-04, US-05, US-06, US-07, voici les adresses IP correspondantes :
23.21.118.19134.206.23.17350.16.249.952.4.160.21454.87.8.3454.156.35.25152.54.89.23818.205.178.15
Pour l’instance US-08, voici les adresses IP correspondantes :
52.151.246.5152.170.163.18240.76.166.15740.76.166.17040.76.166.16740.76.166.16140.76.166.15640.76.166.16640.76.166.16040.88.51.7452.154.67.1740.76.166.8040.76.166.8440.76.166.8540.76.166.8140.76.166.7140.76.166.14440.76.166.145
Pour l’instance US-10, voici les adresses IP correspondantes :
100.25.232.16435.168.86.17952.7.44.1173.92.153.1835.172.3.12950.19.162.19
Pour les instances EU-01 et EU-02, voici les adresses IP correspondantes :
52.58.142.24252.29.193.12135.158.29.22818.157.135.973.123.166.463.64.27.363.65.88.253.68.144.1883.70.107.88
Pour l’instance AU-01, voici les adresses IP correspondantes :
13.210.1.14513.211.70.15913.238.45.5452.65.73.16754.153.242.23954.206.45.213
Pour l’instance ID-01, voici les adresses IP correspondantes :
108.136.157.246108.137.30.20716.78.128.7116.78.14.13416.78.162.20843.218.73.35
Pour l’instance JP-01, voici les adresses IP correspondantes :
13.159.155.21254.199.221.24113.192.23.1654.250.120.13918.181.114.2323.114.38.100
Pour l’instance KR-01, voici les adresses IP correspondantes :
43.200.215.452.79.67.17552.79.113.603.34.212.9254.116.134.2313.37.197.225
Étape 1.1 : Configurer la table
Si vous le souhaitez, configurez une nouvelle base de données et un nouveau schéma pour accueillir votre table source.
CREATE DATABASE BRAZE_CLOUD_PRODUCTION;
CREATE SCHEMA BRAZE_CLOUD_PRODUCTION.INGESTION;
Créez une table (ou une vue) à utiliser pour votre intégration CDI.
CREATE TABLE BRAZE_CLOUD_PRODUCTION.INGESTION.USERS_ATTRIBUTES_SYNC (
updated_at timestamptz default sysdate,
--at least one of external_id, alias_name and alias_label, or braze_id is required
external_id varchar,
--if using user alias, both alias_name and alias_label are required
alias_label varchar,
alias_name varchar,
--braze_id can only be used to update existing users created through the Braze SDK
braze_id varchar,
--If you include both email and phone, email is used as the primary identifier
email varchar,
phone varchar,
payload varchar(max)
)
Vous pouvez nommer la base de données, le schéma et la table comme vous le souhaitez, mais les noms des colonnes doivent correspondre à la définition précédente.
UPDATED_AT- Moment où cette ligne a été mise à jour dans la table ou ajoutée à celle-ci. Braze synchronise les lignes dont la valeurUPDATED_ATest postérieure à la dernière valeur synchronisée. Les lignes dont l’horodatage correspond exactement à la limite peuvent être synchronisées de nouveau si de nouvelles lignes partagent ce même horodatage.- Colonnes d’identifiant utilisateur - Votre table peut contenir une ou plusieurs colonnes d’identifiant utilisateur. Chaque ligne ne doit contenir qu’un seul identifiant (soit
external_id, soit la combinaison dealias_nameetalias_label, soitbraze_id,emailouphone). Une table source peut comporter des colonnes pour un, deux, trois, quatre ou les cinq types d’identifiants.EXTERNAL_ID- Identifie l’utilisateur à mettre à jour. Cette valeur doit correspondre à la valeurexternal_idutilisée dans Braze.ALIAS_NAMEetALIAS_LABEL- Ces deux colonnes créent un objet alias d’utilisateur.alias_namedoit être un identifiant unique, etalias_labelprécise le type d’alias. Les utilisateurs peuvent avoir plusieurs alias avec des libellés différents, mais un seulalias_nameparalias_label.BRAZE_ID- Identifiant utilisateur Braze. Il est généré par le SDK de Braze, et il est impossible de créer de nouveaux utilisateurs à partir d’un ID Braze via Cloud Data Ingestion. Pour créer de nouveaux utilisateurs, indiquez un ID utilisateur externe ou un alias d’utilisateur.EMAIL- Adresse e-mail de l’utilisateur. S’il existe plusieurs profils avec la même adresse e-mail, le profil mis à jour le plus récemment est prioritaire pour les mises à jour. Si vous incluez à la fois l’e-mail et le téléphone, l’e-mail sert d’identifiant principal.PHONE- Numéro de téléphone de l’utilisateur. S’il existe plusieurs profils avec le même numéro de téléphone, le profil mis à jour le plus récemment est prioritaire pour les mises à jour.
payload- Chaîne de caractères JSON contenant les champs à synchroniser avec l’utilisateur dans Braze.
Étape 1.2 : Créer l’utilisateur et accorder les autorisations
CREATE USER braze_user PASSWORD '{password}';
GRANT USAGE ON SCHEMA BRAZE_CLOUD_PRODUCTION.INGESTION to braze_user;
GRANT SELECT ON TABLE USERS_ATTRIBUTES_SYNC TO braze_user;
Il s’agit des autorisations minimales requises pour cet utilisateur. Si vous créez plusieurs intégrations CDI, vous pouvez accorder des autorisations sur un schéma ou gérer les autorisations à l’aide d’un groupe.
Étape 1.3 : Autoriser l’accès aux adresses IP de Braze
Si vous disposez d’un pare-feu ou d’autres politiques réseau, vous devez donner à Braze un accès réseau à votre instance Redshift. Voici un exemple d’endpoint d’URL Redshift : « example-cluster.ap-northeast-2.redshift.amazonaws.com ».
Quelques points importants à retenir :
- Vous devrez peut-être aussi modifier vos groupes de sécurité pour permettre à Braze d’accéder à vos données dans Redshift.
- Veillez à autoriser explicitement le trafic entrant sur les adresses IP du tableau et sur le port utilisé pour interroger votre cluster Redshift (5439 par défaut). Vous devez autoriser explicitement la connectivité TCP Redshift sur ce port, même si les règles entrantes sont définies sur « tout autoriser ».
- L’endpoint du cluster Redshift doit être accessible publiquement pour que Braze puisse se connecter à votre cluster.
- Si vous ne souhaitez pas que votre cluster Redshift soit accessible publiquement, vous pouvez configurer un VPC et une instance EC2 pour utiliser un tunnel SSH afin d’accéder aux données Redshift. Pour plus d’informations, consultez cet article du centre de connaissances AWS.
Autorisez l’accès depuis les adresses IP suivantes, correspondant à la région de votre tableau de bord de Braze.
Pour les instances US-01, US-02, US-03, US-04, US-05, US-06, US-07, voici les adresses IP correspondantes :
23.21.118.19134.206.23.17350.16.249.952.4.160.21454.87.8.3454.156.35.25152.54.89.23818.205.178.15
Pour l’instance US-08, voici les adresses IP correspondantes :
52.151.246.5152.170.163.18240.76.166.15740.76.166.17040.76.166.16740.76.166.16140.76.166.15640.76.166.16640.76.166.16040.88.51.7452.154.67.1740.76.166.8040.76.166.8440.76.166.8540.76.166.8140.76.166.7140.76.166.14440.76.166.145
Pour l’instance US-10, voici les adresses IP correspondantes :
100.25.232.16435.168.86.17952.7.44.1173.92.153.1835.172.3.12950.19.162.19
Pour les instances EU-01 et EU-02, voici les adresses IP correspondantes :
52.58.142.24252.29.193.12135.158.29.22818.157.135.973.123.166.463.64.27.363.65.88.253.68.144.1883.70.107.88
Pour l’instance AU-01, voici les adresses IP correspondantes :
13.210.1.14513.211.70.15913.238.45.5452.65.73.16754.153.242.23954.206.45.213
Pour l’instance ID-01, voici les adresses IP correspondantes :
108.136.157.246108.137.30.20716.78.128.7116.78.14.13416.78.162.20843.218.73.35
Pour l’instance JP-01, voici les adresses IP correspondantes :
13.159.155.21254.199.221.24113.192.23.1654.250.120.13918.181.114.2323.114.38.100
Pour l’instance KR-01, voici les adresses IP correspondantes :
43.200.215.452.79.67.17552.79.113.603.34.212.9254.116.134.2313.37.197.225
Étape 1.1 : Configurer la table
Si vous le souhaitez, configurez un nouveau projet ou jeu de données pour accueillir votre table source.
CREATE SCHEMA BRAZE-CLOUD-PRODUCTION.INGESTION;
Créez une ou plusieurs tables à utiliser pour votre intégration CDI avec les champs suivants :
CREATE TABLE `BRAZE-CLOUD-PRODUCTION.INGESTION.USERS_ATTRIBUTES_SYNC`
(
updated_at TIMESTAMP DEFAULT current_timestamp,
--At least one of external_id, alias_name and alias_label, or braze_id is required
external_id STRING,
--If using user alias, both alias_name and alias_label are required
alias_name STRING,
alias_label STRING,
--braze_id can only be used to update existing users created through the Braze SDK
braze_id STRING,
--If you include both email and phone, email is used as the primary identifier
email STRING,
phone STRING,
payload JSON
);
| Nom du champ | Type | Mode |
|---|---|---|
UPDATED_AT |
TIMESTAMP | REQUIRED |
payload |
JSON | REQUIRED |
EXTERNAL_ID |
STRING | NULLABLE |
ALIAS_NAME |
STRING | NULLABLE |
ALIAS_LABEL |
STRING | NULLABLE |
BRAZE_ID |
STRING | NULLABLE |
EMAIL |
STRING | NULLABLE |
PHONE |
STRING | NULLABLE |
Vous pouvez nommer le projet, le jeu de données et la table comme vous le souhaitez, mais les noms des colonnes doivent correspondre à la définition précédente.
UPDATED_AT- Moment où cette ligne a été mise à jour dans la table ou ajoutée à celle-ci. Braze synchronise les lignes dont la valeurUPDATED_ATest postérieure à la dernière valeur synchronisée. Les lignes dont l’horodatage correspond exactement à la limite peuvent être synchronisées de nouveau si de nouvelles lignes partagent ce même horodatage.- Colonnes d’identifiant utilisateur - Votre table peut contenir une ou plusieurs colonnes d’identifiant utilisateur. Chaque ligne ne doit contenir qu’un seul identifiant (soit
external_id, soit la combinaison dealias_nameetalias_label, soitbraze_id,emailouphone). Une table source peut comporter des colonnes pour un, deux, trois, quatre ou les cinq types d’identifiants.EXTERNAL_ID- Identifie l’utilisateur à mettre à jour. Cette valeur doit correspondre à la valeurexternal_idutilisée dans Braze.ALIAS_NAMEetALIAS_LABEL- Ces deux colonnes créent un objet alias d’utilisateur.alias_namedoit être un identifiant unique, etalias_labelprécise le type d’alias. Les utilisateurs peuvent avoir plusieurs alias avec des libellés différents, mais un seulalias_nameparalias_label.BRAZE_ID- Identifiant utilisateur Braze. Il est généré par le SDK de Braze, et il est impossible de créer de nouveaux utilisateurs à partir d’un ID Braze via Cloud Data Ingestion. Pour créer de nouveaux utilisateurs, indiquez un ID utilisateur externe ou un alias d’utilisateur.EMAIL- Adresse e-mail de l’utilisateur. S’il existe plusieurs profils avec la même adresse e-mail, le profil mis à jour le plus récemment est prioritaire pour les mises à jour. Si vous incluez à la fois l’e-mail et le téléphone, l’e-mail sert d’identifiant principal.PHONE- Numéro de téléphone de l’utilisateur. S’il existe plusieurs profils avec le même numéro de téléphone, le profil mis à jour le plus récemment est prioritaire pour les mises à jour.
payload- Chaîne de caractères JSON contenant les champs à synchroniser avec l’utilisateur dans Braze.
Partitionnement BigQuery
CDI prend en charge les partitions pour BigQuery. Si vous partitionnez selon une fonction de UPDATED_AT (par exemple, avec une granularité au jour, à la semaine ou à l’heure, selon la taille de votre jeu de données), BigQuery peut réduire le volume de données à analyser. Cela améliore les performances et l’efficacité pour les très grandes tables.
Ne partitionnez pas selon d’autres champs. Testez différentes configurations pour trouver la plus adaptée à vos données.
Toutes les requêtes CDI filtrent sur UPDATED_AT, mais ce comportement pourrait évoluer. Concevez le schéma de votre table de façon à ce que les requêtes n’aient pas besoin d’inclure cette clause.
Pour plus d’informations, consultez la documentation de BigQuery sur le partitionnement.
Étape 1.2 : Créer des identifiants pour Braze
Créez dans GCP un compte de service que Braze utilisera pour se connecter à vos tables et en lire les données. Le compte de service doit disposer des autorisations suivantes :
- BigQuery Connection User : permet à Braze d’établir des connexions.
- BigQuery User : permet à Braze d’exécuter des requêtes, de lire les métadonnées des jeux de données et de lister les tables.
- BigQuery Data Viewer : permet à Braze de consulter les jeux de données et leur contenu.
- BigQuery Job User : permet à Braze d’exécuter des jobs.
Braze peut accéder au compte de service avec l’une des méthodes d’authentification suivantes :
- Workload Identity Federation : Braze emprunte l’identité du compte de service avec une identité de courte durée, vous n’avez donc pas à créer ni à importer de clé.
- Clé de compte de service : vous importez dans Braze une clé JSON pour le compte de service.
Les identifiants existants par clé de compte de service continuent de fonctionner, et vous n’avez pas besoin de les migrer. Un même identifiant Workload Identity Federation peut servir à la fois pour les sources BigQuery et Google Cloud Storage.
Configurez un pool d’identités de charge de travail, un fournisseur et le compte de service, puis liez le principal Braze au compte de service. Pour connaître les étapes, consultez Configurer Google Cloud pour Workload Identity Federation. Si vous avez déjà configuré Workload Identity Federation pour une source Google Cloud Storage, inutile de recommencer. Accordez au compte de service existant les autorisations indiquées dans cette étape.
Après avoir créé le compte de service et accordé les autorisations, générez une clé JSON. Pour plus d’informations, consultez Créer et supprimer des clés de compte de service. Vous importerez cette clé dans le tableau de bord de Braze lors d’une étape ultérieure.
Étape 1.3 : Autoriser l’accès aux adresses IP de Braze
Si des politiques réseau sont en place, vous devez donner à Braze un accès réseau à votre instance BigQuery. Autorisez l’accès depuis les adresses IP suivantes, correspondant à la région de votre tableau de bord de Braze.
Pour les instances US-01, US-02, US-03, US-04, US-05, US-06, US-07, voici les adresses IP correspondantes :
23.21.118.19134.206.23.17350.16.249.952.4.160.21454.87.8.3454.156.35.25152.54.89.23818.205.178.15
Pour l’instance US-08, voici les adresses IP correspondantes :
52.151.246.5152.170.163.18240.76.166.15740.76.166.17040.76.166.16740.76.166.16140.76.166.15640.76.166.16640.76.166.16040.88.51.7452.154.67.1740.76.166.8040.76.166.8440.76.166.8540.76.166.8140.76.166.7140.76.166.14440.76.166.145
Pour l’instance US-10, voici les adresses IP correspondantes :
100.25.232.16435.168.86.17952.7.44.1173.92.153.1835.172.3.12950.19.162.19
Pour les instances EU-01 et EU-02, voici les adresses IP correspondantes :
52.58.142.24252.29.193.12135.158.29.22818.157.135.973.123.166.463.64.27.363.65.88.253.68.144.1883.70.107.88
Pour l’instance AU-01, voici les adresses IP correspondantes :
13.210.1.14513.211.70.15913.238.45.5452.65.73.16754.153.242.23954.206.45.213
Pour l’instance ID-01, voici les adresses IP correspondantes :
108.136.157.246108.137.30.20716.78.128.7116.78.14.13416.78.162.20843.218.73.35
Pour l’instance JP-01, voici les adresses IP correspondantes :
13.159.155.21254.199.221.24113.192.23.1654.250.120.13918.181.114.2323.114.38.100
Pour l’instance KR-01, voici les adresses IP correspondantes :
43.200.215.452.79.67.17552.79.113.603.34.212.9254.116.134.2313.37.197.225
Étape 1.1 : Configurer la table
Si vous le souhaitez, configurez un nouveau catalogue ou schéma pour accueillir votre table source.
CREATE SCHEMA BRAZE-CLOUD-PRODUCTION.INGESTION;
Créez une ou plusieurs tables à utiliser pour votre intégration CDI avec les champs suivants :
CREATE TABLE `BRAZE-CLOUD-PRODUCTION.INGESTION.USERS_ATTRIBUTES_SYNC`
(
updated_at TIMESTAMP DEFAULT current_timestamp(),
--At least one of external_id, alias_name and alias_label, or braze_id is required
external_id STRING,
--If using user alias, both alias_name and alias_label are required
alias_name STRING,
alias_label STRING,
--braze_id can only be used to update existing users created through the Braze SDK
braze_id STRING,
--If you include both email and phone, email is used as the primary identifier
email STRING,
phone STRING,
payload STRING, STRUCT, or MAP
);
| Nom du champ | Type | Mode |
|---|---|---|
UPDATED_AT |
TIMESTAMP | REQUIRED |
payload |
STRING, STRUCT ou MAP | REQUIRED |
EXTERNAL_ID |
STRING | NULLABLE |
ALIAS_NAME |
STRING | NULLABLE |
ALIAS_LABEL |
STRING | NULLABLE |
BRAZE_ID |
STRING | NULLABLE |
EMAIL |
STRING | NULLABLE |
PHONE |
STRING | NULLABLE |
Vous pouvez nommer le schéma et la table comme vous le souhaitez, mais les noms des colonnes doivent correspondre à la définition précédente.
UPDATED_AT- Moment où cette ligne a été mise à jour dans la table ou ajoutée à celle-ci. Braze synchronise les lignes dont la valeurUPDATED_ATest postérieure à la dernière valeur synchronisée. Les lignes dont l’horodatage correspond exactement à la limite peuvent être synchronisées de nouveau si de nouvelles lignes partagent ce même horodatage.- Colonnes d’identifiant utilisateur - Votre table peut contenir une ou plusieurs colonnes d’identifiant utilisateur. Chaque ligne ne doit contenir qu’un seul identifiant (soit
external_id, soit la combinaison dealias_nameetalias_label, soitbraze_id,emailouphone). Une table source peut comporter des colonnes pour un, deux, trois, quatre ou les cinq types d’identifiants.EXTERNAL_ID- Identifie l’utilisateur à mettre à jour. Cette valeur doit correspondre à la valeurexternal_idutilisée dans Braze.ALIAS_NAMEetALIAS_LABEL- Ces deux colonnes créent un objet alias d’utilisateur.alias_namedoit être un identifiant unique, etalias_labelprécise le type d’alias. Les utilisateurs peuvent avoir plusieurs alias avec des libellés différents, mais un seulalias_nameparalias_label.BRAZE_ID- Identifiant utilisateur Braze. Il est généré par le SDK de Braze, et il est impossible de créer de nouveaux utilisateurs à partir d’un ID Braze via Cloud Data Ingestion. Pour créer de nouveaux utilisateurs, indiquez un ID utilisateur externe ou un alias d’utilisateur.EMAIL- Adresse e-mail de l’utilisateur. S’il existe plusieurs profils avec la même adresse e-mail, le profil mis à jour le plus récemment est prioritaire pour les mises à jour. Si vous incluez à la fois l’e-mail et le téléphone, l’e-mail sert d’identifiant principal.PHONE- Numéro de téléphone de l’utilisateur. S’il existe plusieurs profils avec le même numéro de téléphone, le profil mis à jour le plus récemment est prioritaire pour les mises à jour.
payload- Chaîne de caractères ou struct contenant les champs à synchroniser avec l’utilisateur dans Braze.
Étape 1.2 : Créer des identifiants pour Braze
Braze peut se connecter à Databricks avec l’une des méthodes d’authentification suivantes :
- OAuth M2M (recommandé) : Braze s’authentifie en tant que principal de service Databricks à l’aide d’un ID client et d’un secret client. Databricks recommande l’authentification OAuth M2M pour les connexions non supervisées comme Cloud Data Ingestion.
- Jeton d’accès personnel : Braze s’authentifie avec un jeton généré dans votre espace de travail Databricks.
Les identifiants existants par jeton d’accès personnel continuent de fonctionner, et vous n’avez pas besoin de les migrer. Toutefois, les jetons d’accès personnels expirent souvent selon une planification définie par l’administrateur de votre espace de travail, et les synchronisations s’arrêtent à l’expiration du jeton. Pour faire passer une source existante à OAuth M2M, créez un identifiant OAuth M2M et sélectionnez-le lorsque vous modifiez la source.
Braze se connecte à votre espace de travail Databricks à l’aide d’un principal de service avec l’authentification OAuth M2M. Créez un nouveau principal de service que Braze utilisera, et accordez-lui l’accès à votre entrepôt SQL et à vos tables sources. Braze a besoin des informations suivantes pour se connecter :
- ID client (également appelé ID d’application) du principal de service
- Secret client permettant à Braze de s’authentifier
Créer le principal de service
- Dans votre espace de travail Databricks, sélectionnez votre nom d’utilisateur dans la barre supérieure, puis sélectionnez Settings.
- Accédez à Identity and access, puis sélectionnez Manage à côté de Service principals.
- Sélectionnez Add service principal > Add new.
- Saisissez un nom qui vous aide à identifier le principal de service, par exemple « Braze CDI », puis sélectionnez Add.
- Sélectionnez le principal de service que vous avez créé. Dans l’onglet Configurations, vérifiez que Databricks SQL access est sélectionné.
Générer un secret client
- Sur la page du principal de service, sélectionnez l’onglet Secrets, puis Generate secret.
- Saisissez une durée de vie pour le secret, en jours. Databricks autorise une durée de vie maximale de 730 jours.
- Sélectionnez Generate.
- Copiez les valeurs Secret et Client ID, puis sélectionnez Done.
Conservez l’ID client et le secret en lieu sûr jusqu’à ce que vous deviez les saisir dans le tableau de bord de Braze lors de l’étape de création des identifiants. Databricks n’affiche le secret qu’une seule fois.
Databricks n’autorise pas de durée de vie illimitée pour les secrets des principaux de service. Pensez à remplacer le secret avant son expiration pour maintenir le flux de données vers Braze. Pour connaître les étapes, consultez Mettre à jour le secret client.
Accorder l’accès à l’entrepôt SQL
Braze a besoin de l’autorisation d’exécuter des requêtes sur votre entrepôt SQL, mais pas d’un accès administrateur à l’espace de travail.
- Dans la barre latérale, sélectionnez SQL Warehouses, puis l’entrepôt que Braze doit utiliser.
- Sélectionnez Permissions.
- Recherchez et sélectionnez le principal de service que vous avez créé.
- Dans la liste déroulante des autorisations, sélectionnez Can use, puis Add.
Accorder l’accès aux tables sources
Accordez au principal de service un accès en lecture au catalogue, au schéma et aux tables que vous avez configurés à l’étape 1.1. Utilisez l’ID d’application du principal de service (la même valeur que l’ID client) comme bénéficiaire.
GRANT USE CATALOG ON CATALOG `BRAZE-CLOUD-PRODUCTION` TO `APPLICATION_ID`;
GRANT USE SCHEMA ON SCHEMA `BRAZE-CLOUD-PRODUCTION`.INGESTION TO `APPLICATION_ID`;
GRANT SELECT ON TABLE `BRAZE-CLOUD-PRODUCTION`.INGESTION.USERS_ATTRIBUTES_SYNC TO `APPLICATION_ID`;
Remplacez APPLICATION_ID par l’ID d’application de votre principal de service. Modifiez les autres noms si nécessaire, mais les autorisations doivent correspondre à l’exemple précédent.
Mettre à jour le secret client
Braze stocke un seul secret client par identifiant. Lorsque vous le mettez à jour, toutes les sources et synchronisations qui utilisent cet identifiant passent au nouveau secret. Pour remplacer le secret :
- Dans Databricks, générez un nouveau secret pour le principal de service en suivant les étapes de la section Générer un secret client. Conservez l’ancien secret jusqu’à l’étape 6.
- Dans le tableau de bord de Braze, accédez à Paramètres des données > Cloud Data Ingestion > Identifiants, puis sélectionnez votre identifiant OAuth M2M. La section Utilisé par répertorie toutes les sources et synchronisations qui utilisent cet identifiant.
- Mettez en pause les synchronisations qui utilisent cet identifiant, ou planifiez la mise à jour à un moment où aucune d’entre elles n’est programmée. Vous éviterez ainsi qu’une synchronisation démarre pendant la mise à jour de l’identifiant.
- Sélectionnez Modifier l’identifiant, saisissez le nouveau secret client, puis sélectionnez Enregistrer. La modification s’applique à toutes les sources et synchronisations qui utilisent cet identifiant.
- Reprenez les synchronisations que vous avez mises en pause.
- Une fois que Braze a enregistré le nouveau secret, supprimez l’ancien secret dans Databricks.
Pour que Braze puisse accéder à Databricks, vous devez créer un jeton d’accès personnel.
- Dans votre espace de travail Databricks, sélectionnez votre nom d’utilisateur Databricks dans la barre supérieure, puis sélectionnez User Settings dans la liste déroulante.
- Dans l’onglet Access tokens, sélectionnez Generate new token.
- Saisissez un commentaire qui vous aide à identifier ce jeton, par exemple « Braze CDI », et définissez une durée de vie illimitée en laissant vide le champ Lifetime (days).
- Sélectionnez Generate.
- Copiez le jeton affiché, puis sélectionnez Done.
Conservez le jeton en lieu sûr jusqu’à ce que vous deviez le saisir dans le tableau de bord de Braze lors de l’étape de création des identifiants.
Étape 1.3 : Autoriser l’accès aux adresses IP de Braze
Si des politiques réseau sont en place, vous devez donner à Braze un accès réseau à votre instance Databricks. Autorisez l’accès depuis les adresses IP suivantes, correspondant à la région de votre tableau de bord de Braze.
Pour les instances US-01, US-02, US-03, US-04, US-05, US-06, US-07, voici les adresses IP correspondantes :
23.21.118.19134.206.23.17350.16.249.952.4.160.21454.87.8.3454.156.35.25152.54.89.23818.205.178.15
Pour l’instance US-08, voici les adresses IP correspondantes :
52.151.246.5152.170.163.18240.76.166.15740.76.166.17040.76.166.16740.76.166.16140.76.166.15640.76.166.16640.76.166.16040.88.51.7452.154.67.1740.76.166.8040.76.166.8440.76.166.8540.76.166.8140.76.166.7140.76.166.14440.76.166.145
Pour l’instance US-10, voici les adresses IP correspondantes :
100.25.232.16435.168.86.17952.7.44.1173.92.153.1835.172.3.12950.19.162.19
Pour les instances EU-01 et EU-02, voici les adresses IP correspondantes :
52.58.142.24252.29.193.12135.158.29.22818.157.135.973.123.166.463.64.27.363.65.88.253.68.144.1883.70.107.88
Pour l’instance AU-01, voici les adresses IP correspondantes :
13.210.1.14513.211.70.15913.238.45.5452.65.73.16754.153.242.23954.206.45.213
Pour l’instance ID-01, voici les adresses IP correspondantes :
108.136.157.246108.137.30.20716.78.128.7116.78.14.13416.78.162.20843.218.73.35
Pour l’instance JP-01, voici les adresses IP correspondantes :
13.159.155.21254.199.221.24113.192.23.1654.250.120.13918.181.114.2323.114.38.100
Pour l’instance KR-01, voici les adresses IP correspondantes :
43.200.215.452.79.67.17552.79.113.603.34.212.9254.116.134.2313.37.197.225
Étape 1.1 : Configurer le principal de service et accorder l’accès
Braze se connecte à votre entrepôt Fabric à l’aide d’un principal de service avec l’authentification Entra ID. Créez un nouveau principal de service que Braze utilisera, et accordez l’accès aux ressources Fabric selon vos besoins. Braze a besoin des informations suivantes pour se connecter :
- ID de locataire (également appelé répertoire) de votre compte Azure
- ID de principal (également appelé ID d’application) pour le principal de service
- Secret client pour permettre à Braze de s’authentifier
- Dans le portail Azure, accédez au centre d’administration Microsoft Entra, puis à App Registrations.
- Sélectionnez + New registration sous Identity > Applications > App registrations.
- Saisissez un nom et sélectionnez
Accounts in this organizational directory onlycomme type de compte pris en charge. Ensuite, sélectionnez Register. - Sélectionnez l’application (principal de service) que vous venez de créer, puis accédez à Certificates & secrets > + New client secret.
- Saisissez une description pour le secret et définissez une période d’expiration. Ensuite, sélectionnez Add.
- Notez le secret client créé afin de l’utiliser lors de la configuration de Braze.
Azure n’autorise pas d’expiration illimitée pour les secrets des principaux de service. Pensez à actualiser les identifiants avant leur expiration pour maintenir le flux de données vers Braze.
Étape 1.2 : Accorder l’accès aux ressources Fabric
Autorisez Braze à se connecter à votre instance Fabric. Dans votre portail d’administration Fabric, accédez à Settings > Governance and insights > Admin portal > Tenant settings.
- Dans Developer settings, activez Service principals can use Fabric APIs pour que Braze puisse se connecter avec Microsoft Entra ID.
- Dans OneLake settings, activez Users can access data stored in OneLake with apps external to Fabric pour que le principal de service puisse accéder aux données depuis une application externe.
Étape 1.3 : Configurer un espace de travail partagé et accorder l’accès
Toutes les ressources Fabric que vous souhaitez connecter à Braze doivent se trouver dans un espace de travail partagé. Si vous n’utilisiez jusqu’à présent que l’espace par défaut My Workspace, créez un nouvel espace de travail partagé :
- Dans le menu de navigation, sélectionnez Workspaces, puis + New workspace.
- Saisissez un Name pour l’espace de travail, puis sélectionnez Apply.
Une fois l’espace de travail partagé créé, accordez-y l’accès au principal de service :
- Sélectionnez l’espace de travail, puis Manage Access.
- Sélectionnez + Add people or groups.
- Recherchez et sélectionnez le nom du principal de service créé à l’étape 1.1. S’il n’apparaît pas, vérifiez que vous avez bien activé le paramètre Service principals can use Fabric APIs à l’étape 1.2.
- Dans la liste déroulante des rôles, sélectionnez Contributor.
Le principal de service peut désormais accéder aux ressources d’entrepôt Fabric de cet espace de travail via leurs endpoints SQL, y compris l’entrepôt à utiliser pour Braze.
Étape 1.4 : Configurer la table
Braze prend en charge les tables comme les vues dans les entrepôts Fabric. Si vous devez créer un nouvel entrepôt, créez-le dans l’espace de travail partagé de l’étape 1.3. Dans la console Fabric, accédez à Create > Data Warehouse > Warehouse.
CREATE OR ALTER TABLE [warehouse].[schema].[CDI_table_name]
(
UPDATED_AT DATETIME2(6) NOT NULL,
PAYLOAD VARCHAR NOT NULL,
--at least one of external_id, alias_name and alias_label, email, phone, or braze_id is required
EXTERNAL_ID VARCHAR,
--if using user alias, both alias_name and alias_label are required
ALIAS_NAME VARCHAR,
ALIAS_LABEL VARCHAR,
--braze_id can only be used to update existing users created through the Braze SDK
BRAZE_ID VARCHAR,
--If you include both email and phone, email is used as the primary identifier
EMAIL VARCHAR,
PHONE VARCHAR
)
GO
Vous pouvez nommer l’entrepôt, le schéma et la table ou la vue comme vous le souhaitez, mais les noms des colonnes doivent correspondre à la définition précédente.
UPDATED_AT- Moment où cette ligne a été mise à jour dans la table ou ajoutée à celle-ci. Braze synchronise les lignes dont la valeurUPDATED_ATest postérieure à la dernière valeur synchronisée. Les lignes dont l’horodatage correspond exactement à la limite peuvent être synchronisées de nouveau si de nouvelles lignes partagent ce même horodatage.- Colonnes d’identifiant utilisateur - Votre table peut contenir une ou plusieurs colonnes d’identifiant utilisateur. Chaque ligne ne doit contenir qu’un seul identifiant (soit
external_id, soit la combinaison dealias_nameetalias_label, soitbraze_id,emailouphone). Une table source peut comporter des colonnes pour un, deux, trois, quatre ou les cinq types d’identifiants.EXTERNAL_ID- Identifie l’utilisateur à mettre à jour. Cette valeur doit correspondre à la valeurexternal_idutilisée dans Braze.ALIAS_NAMEetALIAS_LABEL- Ces deux colonnes créent un objet alias d’utilisateur.alias_namedoit être un identifiant unique, etalias_labelprécise le type d’alias. Les utilisateurs peuvent avoir plusieurs alias avec des libellés différents, mais un seulalias_nameparalias_label.BRAZE_ID- Identifiant utilisateur Braze. Il est généré par le SDK de Braze, et il est impossible de créer de nouveaux utilisateurs à partir d’un ID Braze via Cloud Data Ingestion. Pour créer de nouveaux utilisateurs, indiquez un ID utilisateur externe ou un alias d’utilisateur.EMAIL- Adresse e-mail de l’utilisateur. S’il existe plusieurs profils avec la même adresse e-mail, le profil mis à jour le plus récemment est prioritaire pour les mises à jour. Si vous incluez à la fois l’e-mail et le téléphone, l’e-mail sert d’identifiant principal.PHONE- Numéro de téléphone de l’utilisateur. S’il existe plusieurs profils avec le même numéro de téléphone, le profil mis à jour le plus récemment est prioritaire pour les mises à jour.
payload- Chaîne de caractères JSON contenant les champs à synchroniser avec l’utilisateur dans Braze.
Étape 1.5 : Obtenir la chaîne de connexion de l’entrepôt
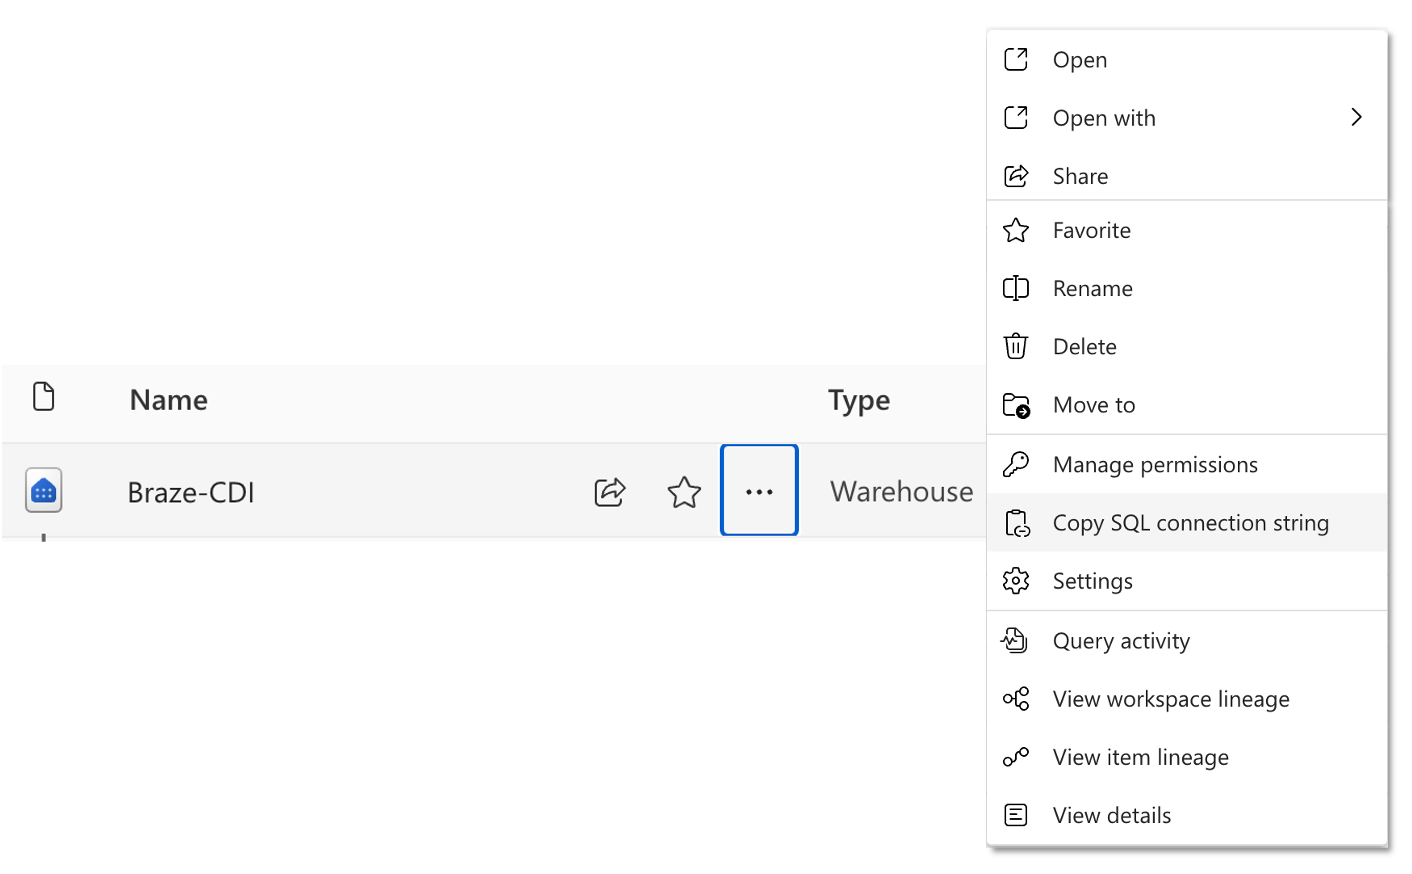
Pour récupérer l’endpoint SQL de votre entrepôt, accédez à l’espace de travail dans Fabric, survolez le nom de l’entrepôt dans la liste des éléments et sélectionnez Copy SQL connection string.
Étape 1.6 : Autoriser les adresses IP de Braze dans le pare-feu (facultatif)
Selon la configuration de votre compte Microsoft Fabric, vous devrez peut-être autoriser les adresses IP suivantes dans votre pare-feu pour accepter le trafic provenant de Braze. Pour plus d’informations sur cette opération, consultez la documentation sur l’accès conditionnel Entra.
Pour les instances US-01, US-02, US-03, US-04, US-05, US-06, US-07, voici les adresses IP correspondantes :
23.21.118.19134.206.23.17350.16.249.952.4.160.21454.87.8.3454.156.35.25152.54.89.23818.205.178.15
Pour l’instance US-08, voici les adresses IP correspondantes :
52.151.246.5152.170.163.18240.76.166.15740.76.166.17040.76.166.16740.76.166.16140.76.166.15640.76.166.16640.76.166.16040.88.51.7452.154.67.1740.76.166.8040.76.166.8440.76.166.8540.76.166.8140.76.166.7140.76.166.14440.76.166.145
Pour l’instance US-10, voici les adresses IP correspondantes :
100.25.232.16435.168.86.17952.7.44.1173.92.153.1835.172.3.12950.19.162.19
Pour les instances EU-01 et EU-02, voici les adresses IP correspondantes :
52.58.142.24252.29.193.12135.158.29.22818.157.135.973.123.166.463.64.27.363.65.88.253.68.144.1883.70.107.88
Pour l’instance AU-01, voici les adresses IP correspondantes :
13.210.1.14513.211.70.15913.238.45.5452.65.73.16754.153.242.23954.206.45.213
Pour l’instance ID-01, voici les adresses IP correspondantes :
108.136.157.246108.137.30.20716.78.128.7116.78.14.13416.78.162.20843.218.73.35
Pour l’instance JP-01, voici les adresses IP correspondantes :
13.159.155.21254.199.221.24113.192.23.1654.250.120.13918.181.114.2323.114.38.100
Pour l’instance KR-01, voici les adresses IP correspondantes :
43.200.215.452.79.67.17552.79.113.603.34.212.9254.116.134.2313.37.197.225
Étape 2 : Créer une nouvelle source dans le tableau de bord de Braze
Dans le tableau de bord de Braze, accédez à Paramètres des données > Cloud Data Ingestion > Sources, sélectionnez Ajouter une source de données, puis Snowflake.
Étape 2.1 : Ajouter les informations de connexion Snowflake
Choisissez un nom pour votre source. Saisissez un Nom de l’identifiant, puis sélectionnez Workload Identity Federation ou Key pair selon l’utilisateur créé à l’étape 1.4.
Avant de continuer, vérifiez la valeur que vous saisissez dans Localisateur de compte Snowflake.
Dans le champ Localisateur de compte Snowflake, saisissez votre identifiant de compte Snowflake. Saisissez uniquement la valeur de l’identifiant de compte, par exemple myorganization-myaccount. N’incluez pas https://, .snowflakecomputing.com ni aucun chemin.
Pour trouver votre identifiant de compte Snowflake :
- Dans Snowsight, sélectionnez le menu de votre compte.
- Sélectionnez View account details.
- Copiez la valeur Account identifier.
- Si vous la copiez depuis une URL Snowflake, utilisez uniquement la valeur située avant
.snowflakecomputing.com.
Étape 2.2 : Authentifier l’utilisateur Snowflake
Dans le formulaire d’identifiants, effectuez les étapes dans l’ordre :
- Saisissez Localisateur de compte, Nom d’utilisateur et Rôle.
- Sélectionnez Créer un utilisateur ou Modifier l’utilisateur, puis Copier l’instruction dès que cette option est disponible.
- Exécutez cette instruction dans une feuille de calcul Snowflake. Pour savoir ce que fait l’instruction, consultez Configurer Snowflake pour Workload Identity Federation.
- Revenez dans Braze et sélectionnez Enregistrer l’identifiant.
- Saisissez l’entrepôt, la base de données et le schéma, sélectionnez Tester la connexion, puis Se connecter à la source.
Saisissez Localisateur de compte, Nom d’utilisateur et Rôle, puis sélectionnez Enregistrer les identifiants et générer une clé RSA. Dans Snowflake, ajoutez la clé publique affichée dans le tableau de bord à l’utilisateur que vous avez créé pour Braze.
Pour plus d’informations sur cette opération, consultez la documentation de Snowflake. Si vous souhaitez effectuer une rotation des clés à tout moment, Braze peut générer une nouvelle paire de clés et vous fournir la nouvelle clé publique.
ALTER USER BRAZE_INGESTION_USER SET RSA_PUBLIC_KEY='MIIBIjANBgkqhkiG9w0BA...';
Pour effectuer une rotation de la clé ultérieurement, accédez à Paramètres des données > Cloud Data Ingestion > Identifiants, ouvrez l’identifiant sous Identifiants d’accès aux données Snowflake, puis sélectionnez Effectuer la rotation de l’identifiant. Pour en savoir plus sur la fenêtre modale de détails, consultez Examiner un identifiant Snowflake.
Après avoir ajouté la clé dans Snowflake, sélectionnez Tester la connexion, puis Se connecter à la source.
Dans le tableau de bord de Braze, accédez à Paramètres des données > Cloud Data Ingestion > Sources, sélectionnez Ajouter une source de données, puis Amazon Redshift.
Étape 2.1 : Ajouter les informations de connexion Redshift et la table source
Choisissez un nom pour votre source et saisissez vos identifiants et votre configuration Redshift. Si vous utilisez un tunnel réseau privé, activez le curseur et saisissez les informations du tunnel. Passez ensuite à l’étape suivante.
Dans le tableau de bord de Braze, le champ Nom de la base de données n’accepte que les lettres (A–Z, a–z), les chiffres (0–9) et les traits de soulignement (_), même si Amazon Redshift prend en charge d’autres caractères dans les identifiants de base de données.
Étape 2.2 : Tester la connexion et se connecter à la source
Sélectionnez ensuite Tester la connexion. Une fois le test réussi, finalisez les paramètres restants et sélectionnez Se connecter à la source. Si la connexion échoue, un message d’erreur s’affiche pour vous aider à résoudre le problème.
Résolution des problèmes : identifiant d’instantané non valide
Si Braze renvoie une erreur Invalid snapshot identifier lors de Tester la connexion ou de la configuration de la synchronisation, Redshift ne parvient pas à résoudre la référence d’instantané utilisée lors de l’interrogation de votre objet source.
Dans Redshift, un instantané est une sauvegarde d’un cluster à un instant donné. Chaque instantané possède un identifiant unique que Redshift utilise pour faire référence à cet état de sauvegarde. Pour plus d’informations, consultez Instantanés et sauvegardes Amazon Redshift.
Cette erreur peut se produire lorsque des métadonnées changent pendant que Braze valide l’objet source, par exemple lors d’une copie d’instantané, d’une restauration ou d’opérations liées à la réplication. Pour plus d’informations, consultez la copie d’instantanés vers une autre région AWS et la restauration d’un cluster à partir d’un instantané.
Pour résoudre le problème :
- Vérifiez les paramètres de la source dans Braze, notamment l’endpoint du cluster, la base de données, le schéma et le nom de l’objet.
- Exécutez la même requête directement dans Redshift pour vérifier que la table ou la vue est lisible et stable.
- Réessayez une fois terminées les activités en cours d’instantané, de restauration, de redimensionnement ou de réplication.
- Si le problème persiste, interrogez une vue matérialisée plutôt qu’une table de base qui change fréquemment.
Une vue matérialisée stocke des résultats de requête précalculés que vous pouvez actualiser selon une planification, ce qui peut rendre les lectures plus stables pour les synchronisations CDI. Pour plus d’informations, consultez les vues matérialisées dans Amazon Redshift.
Exemple :
CREATE MATERIALIZED VIEW ingestion.users_attributes_mv AS
SELECT updated_at, external_id, alias_label, alias_name, braze_id, email, phone, payload
FROM ingestion.users_attributes_sync;
REFRESH MATERIALIZED VIEW ingestion.users_attributes_mv;
Après avoir créé la vue matérialisée, utilisez son nom comme objet source dans votre synchronisation CDI Braze à la place de la table de base.
Dans le tableau de bord de Braze, accédez à Paramètres des données > Cloud Data Ingestion > Sources, sélectionnez Ajouter une source de données, puis Google BigQuery.
Étape 2.1 : Ajouter les informations de connexion BigQuery et la table source
Saisissez un nom pour votre source, puis vos identifiants et votre configuration BigQuery :
- Dans Nom de l’identifiant, saisissez un libellé qui vous aide à identifier ces identifiants dans Braze.
- Pour la méthode d’authentification, sélectionnez Workload Identity Federation ou Service Account Key selon les identifiants créés à l’étape 1.2.
- Pour Workload Identity Federation, copiez l’ARN du principal Braze pour votre configuration Google Cloud, puis saisissez le Numéro de projet, l’ID du pool d’identités de charge de travail, l’ID du fournisseur et l’E-mail du compte de service. Pour une clé de compte de service, importez la clé JSON.
Renseignez ensuite les autres champs de configuration.
Étape 2.2 : Tester la connexion et se connecter à la source
Sélectionnez ensuite Tester la connexion. Une fois le test réussi, finalisez les paramètres restants et sélectionnez Se connecter à la source. Si la connexion échoue, un message d’erreur s’affiche pour vous aider à résoudre le problème.
Dans le tableau de bord de Braze, accédez à Paramètres des données > Cloud Data Ingestion > Sources, sélectionnez Ajouter une source de données, puis Databricks.
Étape 2.1 : Ajouter les informations de connexion Databricks et la table source
Saisissez un nom pour votre source, puis vos identifiants et votre configuration Databricks :
- Dans Nom de l’identifiant, saisissez un libellé qui vous aide à identifier ces identifiants dans Braze.
- Dans Méthode d’authentification, sélectionnez OAuth M2M ou Personal Access Token selon les identifiants créés à l’étape 1.2.
- Pour OAuth M2M, saisissez l’ID client et le Secret client de votre principal de service. Pour un jeton d’accès personnel, saisissez le Jeton d’accès.
Passez ensuite à l’étape suivante.
Étape 2.2 : Tester la connexion et se connecter à la source
Sélectionnez ensuite Tester la connexion. Une fois le test réussi, finalisez les paramètres restants et sélectionnez Se connecter à la source. Si la connexion échoue, un message d’erreur s’affiche pour vous aider à résoudre le problème.
Vous devez tester une source avec succès avant de pouvoir la créer. Si vous fermez la page de création, votre source n’est pas enregistrée.
Dans le tableau de bord de Braze, accédez à Paramètres des données > Cloud Data Ingestion > Sources, sélectionnez Ajouter une source de données, puis Microsoft Fabric.
Étape 2.1 : Configurer une synchronisation Cloud Data Ingestion
Choisissez un nom pour votre source et saisissez vos identifiants et votre configuration Microsoft Fabric.
- Nom des identifiants est un libellé pour ces identifiants dans Braze ; vous pouvez y saisir une valeur explicite.
- Consultez les étapes de la section 1 pour savoir comment récupérer l’ID du locataire, l’ID du principal, le secret client et la chaîne de connexion.
Étape 2.2 : Tester la connexion et se connecter à la source
Sélectionnez ensuite Tester la connexion. Une fois le test réussi, finalisez les paramètres restants et sélectionnez Se connecter à la source. Si la connexion échoue, un message d’erreur s’affiche pour vous aider à résoudre le problème.
Vous devez tester une source avec succès avant de pouvoir la créer. Si vous fermez la page de création, votre source n’est pas enregistrée.
Étape 3 : Créer une nouvelle synchronisation dans le tableau de bord de Braze
Accédez à Paramètres des données > Cloud Data Ingestion > Synchronisations, puis sélectionnez Créer une synchronisation de données.
Étape 3.1 : Configurer les détails de la synchronisation et définir vos données
Saisissez un nom pour votre synchronisation. Sélectionnez ensuite une source active et un type de données de synchronisation. Puis sélectionnez Visuel ou Table et saisissez votre table source, ou sélectionnez SQL pour écrire une requête SQL personnalisée. Enfin, sélectionnez Prévisualiser et valider.
Une fois la validation réussie, un aperçu des données s’affiche. Sélectionnez Suivant : Notifications pour continuer. Si la validation échoue, un message d’erreur s’affiche pour vous aider à résoudre le problème.
Vous devez valider une synchronisation avec succès avant de passer aux étapes suivantes. Si vous devez fermer la page de création de la synchronisation, sélectionnez Enregistrer comme brouillon pour conserver votre travail en cours.
Étape 3.2 : Ajouter les préférences de notification
Saisissez une ou plusieurs adresses e-mail de contact pour les notifications d’erreur de synchronisation. Braze utilise ces coordonnées pour envoyer des notifications sur les erreurs d’intégration, comme une perte inattendue de l’accès à une table.
Les adresses e-mail de contact reçoivent uniquement les notifications d’erreurs globales ou au niveau de la synchronisation, comme des tables manquantes ou des problèmes d’autorisations. Elles ne reçoivent pas les problèmes au niveau des lignes. Les erreurs globales signalent des problèmes critiques de connexion qui empêchent l’exécution des synchronisations.
Ces problèmes peuvent inclure :
- Problèmes de connectivité
- Manque de ressources
- Problèmes d’autorisations
- Espace insuffisant dans le niveau de catalogue (synchronisations de catalogue uniquement)
Étape 3.3 : Planification
Enfin, configurez votre synchronisation comme non récurrente ou récurrente.
Les synchronisations non récurrentes s’exécutent uniquement lorsque vous sélectionnez Synchroniser maintenant dans le tableau de bord ou que vous appelez l’endpoint Déclencher une synchronisation.
Les synchronisations récurrentes peuvent s’exécuter aussi souvent que toutes les 5 minutes ou aussi rarement qu’une fois par mois. Par défaut, l’intervalle le plus court que vous pouvez définir dans le tableau de bord est de 15 minutes, ce qui vous aide à maîtriser les coûts de calcul de votre entrepôt et le volume de requêtes. Pour synchroniser jusqu’à toutes les 5 minutes, contactez l’assistance Braze ou votre gestionnaire de la satisfaction client. Braze planifie les synchronisations récurrentes en UTC.
Étape 3.1 : Configurer les détails de la synchronisation et définir vos données
Saisissez un nom pour votre synchronisation. Sélectionnez ensuite une source active et un type de données de synchronisation. Puis sélectionnez Visuel ou Table et saisissez votre table source, ou sélectionnez SQL pour écrire une requête SQL personnalisée. Enfin, sélectionnez Prévisualiser et valider.
Une fois la validation réussie, un aperçu des données s’affiche. Sélectionnez Suivant : Notifications pour continuer. Si la validation échoue, un message d’erreur s’affiche pour vous aider à résoudre le problème.
Vous devez valider une synchronisation avec succès avant de passer aux étapes suivantes. Si vous devez fermer la page de création de la synchronisation, sélectionnez Enregistrer comme brouillon pour conserver votre travail en cours.
Étape 3.2 : Ajouter les préférences de notification
Saisissez une ou plusieurs adresses e-mail de contact pour les notifications d’erreur de synchronisation. Braze utilise ces coordonnées pour envoyer des notifications sur les erreurs d’intégration, comme une perte inattendue de l’accès à une table.
Les adresses e-mail de contact reçoivent uniquement les notifications d’erreurs globales ou au niveau de la synchronisation, comme des tables manquantes ou des problèmes d’autorisations. Elles ne reçoivent pas les problèmes au niveau des lignes. Les erreurs globales signalent des problèmes critiques de connexion qui empêchent l’exécution des synchronisations. Ces problèmes peuvent inclure :
- Problèmes de connectivité
- Manque de ressources
- Problèmes d’autorisations
- Espace insuffisant dans le niveau de catalogue (synchronisations de catalogue uniquement)
Étape 3.3 : Planification
Enfin, configurez votre synchronisation comme non récurrente ou récurrente.
Les synchronisations non récurrentes s’exécutent uniquement lorsque vous sélectionnez Synchroniser maintenant dans le tableau de bord ou que vous appelez l’endpoint Déclencher une synchronisation.
Les synchronisations récurrentes peuvent s’exécuter aussi souvent que toutes les 5 minutes ou aussi rarement qu’une fois par mois. Par défaut, l’intervalle le plus court que vous pouvez définir dans le tableau de bord est de 15 minutes, ce qui vous aide à maîtriser les coûts de calcul de votre entrepôt et le volume de requêtes. Pour synchroniser jusqu’à toutes les 5 minutes, contactez l’assistance Braze ou votre gestionnaire de la satisfaction client. Braze planifie les synchronisations récurrentes en UTC.
Étape 3.1 : Configurer les détails de la synchronisation et définir vos données
Saisissez un nom pour votre synchronisation. Sélectionnez ensuite une source active et un type de données de synchronisation. Puis sélectionnez Visuel ou Table et saisissez votre table source, ou sélectionnez SQL pour écrire une requête SQL personnalisée. Enfin, sélectionnez Prévisualiser et valider.
Une fois la validation réussie, un aperçu des données s’affiche. Sélectionnez Suivant : Notifications pour continuer. Si la validation échoue, un message d’erreur s’affiche pour vous aider à résoudre le problème.
Vous devez valider une synchronisation avec succès avant de passer aux étapes suivantes. Si vous devez fermer la page de création de la synchronisation, sélectionnez Enregistrer comme brouillon pour conserver votre travail en cours.
Étape 3.2 : Ajouter les préférences de notification
Saisissez une ou plusieurs adresses e-mail de contact pour les notifications d’erreur de synchronisation. Braze utilise ces coordonnées pour envoyer des notifications sur les erreurs d’intégration, comme une perte inattendue de l’accès à une table.
Les adresses e-mail de contact reçoivent uniquement les notifications d’erreurs globales ou au niveau de la synchronisation, comme des tables manquantes ou des problèmes d’autorisations. Elles ne reçoivent pas les problèmes au niveau des lignes. Les erreurs globales signalent des problèmes critiques de connexion qui empêchent l’exécution des synchronisations.
Ces problèmes peuvent inclure :
- Problèmes de connectivité
- Manque de ressources
- Problèmes d’autorisations
- Espace insuffisant dans le niveau de catalogue (synchronisations de catalogue uniquement)
Étape 3.3 : Planification
Enfin, configurez votre synchronisation comme non récurrente ou récurrente.
Les synchronisations non récurrentes s’exécutent uniquement lorsque vous sélectionnez Synchroniser maintenant dans le tableau de bord ou que vous appelez l’endpoint Déclencher une synchronisation.
Les synchronisations récurrentes peuvent s’exécuter aussi souvent que toutes les 5 minutes ou aussi rarement qu’une fois par mois. Par défaut, l’intervalle le plus court que vous pouvez définir dans le tableau de bord est de 15 minutes, ce qui vous aide à maîtriser les coûts de calcul de votre entrepôt et le volume de requêtes. Pour synchroniser jusqu’à toutes les 5 minutes, contactez l’assistance Braze ou votre gestionnaire de la satisfaction client. Braze planifie les synchronisations récurrentes en UTC.
Étape 3.1 : Configurer les détails de la synchronisation et définir vos données
Saisissez un nom pour votre synchronisation. Sélectionnez ensuite une source active et un type de données de synchronisation. Puis sélectionnez Visuel ou Table et saisissez votre table source, ou sélectionnez SQL pour écrire une requête SQL personnalisée. Enfin, sélectionnez Prévisualiser et valider.
Une fois la validation réussie, un aperçu des données s’affiche. Sélectionnez Suivant : Notifications pour continuer. Si la validation échoue, un message d’erreur s’affiche pour vous aider à résoudre le problème.
Vous devez valider une synchronisation avec succès avant de passer aux étapes suivantes. Si vous devez fermer la page de création de la synchronisation, sélectionnez Enregistrer comme brouillon pour conserver votre travail en cours.
Étape 3.2 : Ajouter les préférences de notification
Saisissez une ou plusieurs adresses e-mail de contact pour les notifications d’erreur de synchronisation. Braze utilise ces coordonnées pour envoyer des notifications sur les erreurs d’intégration, comme une perte inattendue de l’accès à une table.
Les adresses e-mail de contact reçoivent uniquement les notifications d’erreurs globales ou au niveau de la synchronisation, comme des tables manquantes ou des problèmes d’autorisations. Elles ne reçoivent pas les problèmes au niveau des lignes. Les erreurs globales signalent des problèmes critiques de connexion qui empêchent l’exécution des synchronisations.
Ces problèmes peuvent inclure :
- Problèmes de connectivité
- Manque de ressources
- Problèmes d’autorisations
- Espace insuffisant dans le niveau de catalogue (synchronisations de catalogue uniquement)
Étape 3.3 : Planification
Enfin, configurez votre synchronisation comme non récurrente ou récurrente.
Les synchronisations non récurrentes s’exécutent uniquement lorsque vous sélectionnez Synchroniser maintenant dans le tableau de bord ou que vous appelez l’endpoint Déclencher une synchronisation.
Les synchronisations récurrentes peuvent s’exécuter aussi souvent que toutes les 5 minutes ou aussi rarement qu’une fois par mois. Par défaut, l’intervalle le plus court que vous pouvez définir dans le tableau de bord est de 15 minutes, ce qui vous aide à maîtriser les coûts de calcul de votre entrepôt et le volume de requêtes. Pour synchroniser jusqu’à toutes les 5 minutes, contactez l’assistance Braze ou votre gestionnaire de la satisfaction client. Braze planifie les synchronisations récurrentes en UTC.
Vous devez valider une intégration avec succès avant qu’elle puisse passer de l’état Brouillon à l’état Active. Si vous fermez la page de création, votre intégration est enregistrée, et vous pouvez revenir sur la page de détails pour apporter des modifications et la valider.
Configurer des intégrations ou des utilisateurs supplémentaires (facultatif)
Vous pouvez configurer plusieurs intégrations avec Braze. Lorsque vous créez des synchronisations supplémentaires, vous pouvez réutiliser des identifiants existants si vous vous connectez au compte Snowflake.
Si vous réutilisez le même utilisateur et le même rôle à paire de clés pour plusieurs intégrations, vous n’avez pas besoin d’ajouter à nouveau la clé publique. Un identifiant Workload Identity Federation n’a pas de clé publique à ajouter.
Vous pouvez configurer plusieurs intégrations avec Braze. Lorsque vous créez des synchronisations supplémentaires, vous pouvez réutiliser des identifiants existants si vous vous connectez au même compte Redshift.
Si vous réutilisez le même utilisateur pour plusieurs intégrations, vous ne pouvez pas le supprimer dans le tableau de bord de Braze tant qu’il n’a pas été retiré de toutes les synchronisations actives.
Vous pouvez configurer plusieurs intégrations avec Braze. Lorsque vous créez des synchronisations supplémentaires, vous pouvez réutiliser des identifiants existants si vous vous connectez au même compte BigQuery.
Si vous réutilisez le même utilisateur pour plusieurs intégrations, vous ne pouvez pas le supprimer dans le tableau de bord de Braze tant qu’il n’a pas été retiré de toutes les synchronisations actives.
Vous pouvez configurer plusieurs intégrations avec Braze. Lorsque vous créez des synchronisations supplémentaires, vous pouvez réutiliser des identifiants existants si vous vous connectez au même compte Databricks.
Si vous réutilisez le même utilisateur pour plusieurs intégrations, vous ne pouvez pas le supprimer dans le tableau de bord de Braze tant qu’il n’a pas été retiré de toutes les synchronisations actives.
Vous pouvez configurer plusieurs intégrations avec Braze. Lorsque vous créez des synchronisations supplémentaires, vous pouvez réutiliser des identifiants existants si vous vous connectez au même compte Fabric.
Si vous réutilisez le même utilisateur pour plusieurs intégrations, vous ne pouvez pas le supprimer dans le tableau de bord de Braze tant qu’il n’a pas été retiré de toutes les synchronisations actives.
Exécution de la synchronisation
Une fois activée, votre synchronisation s’exécute selon la planification configurée lors de la configuration. Si vous souhaitez lancer la synchronisation en dehors de sa planification ou récupérer les données les plus récentes, sélectionnez Synchroniser maintenant. Cette exécution n’a aucune incidence sur les futures synchronisations planifiées. Pour lancer automatiquement une synchronisation lorsque vos données sont mises à jour, appelez l’endpoint Déclencher une synchronisation depuis votre pipeline.
Une fois activée, votre synchronisation s’exécute selon la planification configurée lors de la configuration. Si vous souhaitez lancer la synchronisation en dehors de sa planification ou récupérer les données les plus récentes, sélectionnez Synchroniser maintenant. Cette exécution n’a aucune incidence sur les futures synchronisations planifiées. Pour lancer automatiquement une synchronisation lorsque vos données sont mises à jour, appelez l’endpoint Déclencher une synchronisation depuis votre pipeline.
Une fois activée, votre synchronisation s’exécute selon la planification configurée lors de la configuration. Si vous souhaitez lancer la synchronisation en dehors de sa planification ou récupérer les données les plus récentes, sélectionnez Synchroniser maintenant. Cette exécution n’a aucune incidence sur les futures synchronisations planifiées. Pour lancer automatiquement une synchronisation lorsque vos données sont mises à jour, appelez l’endpoint Déclencher une synchronisation depuis votre pipeline.
Une fois activée, votre synchronisation s’exécute selon la planification configurée lors de la configuration. Si vous souhaitez lancer la synchronisation en dehors de sa planification ou récupérer les données les plus récentes, sélectionnez Synchroniser maintenant. Cette exécution n’a aucune incidence sur les futures synchronisations planifiées. Pour lancer automatiquement une synchronisation lorsque vos données sont mises à jour, appelez l’endpoint Déclencher une synchronisation depuis votre pipeline.
Une fois activée, votre synchronisation s’exécute selon la planification configurée lors de la configuration. Si vous souhaitez lancer la synchronisation en dehors de sa planification ou récupérer les données les plus récentes, sélectionnez Synchroniser maintenant. Cette exécution n’a aucune incidence sur les futures synchronisations planifiées. Pour lancer automatiquement une synchronisation lorsque vos données sont mises à jour, appelez l’endpoint Déclencher une synchronisation depuis votre pipeline.